
یادگیری عمیق (Deep Learning) یکی از شاخههای یادگیری ماشین است که با استفاده از شبکههای عصبی چندلایه، به مدلها امکان میدهد الگوهای پیچیده را از دادهها یاد بگیرند و بر اساس آنها پیشبینی یا تصمیمگیری کنند. یادگیری عمیق امروزه در حوزههایی مانند پردازش زبان طبیعی، تشخیص تصویر، ترجمه ماشینی، پردازش گفتار و تحلیل دادههای پزشکی کاربرد دارد.
در این مقاله بررسی میکنیم یادگیری عمیق چیست، چگونه کار میکند و چه تفاوتی با یادگیری ماشین دارد. سپس با شبکههای عصبی و معماریهای مهم یادگیری عمیق، کاربردها و محدودیتهای آن و ابزارهای رایج برای توسعه مدلهای Deep Learning آشنا میشویم.
یادگیری عمیق چیست؟
یادگیری عمیق یکی از زیرشاخههای یادگیری ماشین است که از شبکههای عصبی چندلایه (Neural Networks) برای یادگیری الگوهای پیچیده از دادهها استفاده میکند. در این روش، مدل با پردازش دادهها در لایههای مختلف، میتواند ویژگیهای مرتبط با مسئله را یاد بگیرد و از آنها برای کارهایی مانند طبقهبندی، تشخیص الگو، پیشبینی و تولید محتوا استفاده کند. یادگیری عمیق در حوزههایی مانند پردازش تصویر، پردازش زبان طبیعی، تشخیص گفتار و تحلیل دادههای پزشکی کاربرد دارد.
یکی از تفاوتهای مهم یادگیری عمیق با بسیاری از روشهای سنتی یادگیری ماشین این است که مدل میتواند بخش زیادی از ویژگیهای موردنیاز برای حل مسئله را مستقیما از دادهها یاد بگیرد. برای مثال، در تشخیص تصویر، مدل میتواند از الگوهای سادهتر مانند لبهها و شکلها شروع کند و در لایههای بعدی ویژگیهای پیچیدهتری را برای شناسایی اشیا یاد بگیرد.
شبکه عصبی در یادگیری عمیق از لایههای متعددی تشکیل میشود. داده از لایه ورودی وارد شبکه میشود و پس از عبور از لایههای میانی، در لایه خروجی به نتیجه موردنظر میرسد. در فرایند آموزش، مدل با مقایسه خروجی خود با نتیجه مورد انتظار، پارامترهایش را بهروزرسانی میکند تا عملکرد آن در انجام وظیفه موردنظر بهبود پیدا کند.
برای مثال، در یک سیستم تشخیص تصویر، میتوان مجموعهای از تصاویر را در اختیار مدل قرار داد. مدل در فرایند آموزش، الگوهای موجود در تصاویر را یاد میگیرد و پس از آموزش میتواند برای یک تصویر جدید، بر اساس الگوهایی که آموخته است، پیشبینی کند که تصویر متعلق به چه دستهای است.
یادگیری عمیق چگونه کار میکند؟
یادگیری عمیق با استفاده از شبکههای عصبی مصنوعی چندلایه، الگوها و روابط موجود در دادهها را بهصورت مرحلهای یاد میگیرد. هر لایه از شبکه، بخشی از اطلاعات خروجی لایههای قبلی را دریافت میکند و میتواند الگوهای پیچیدهتری را شناسایی کند. به همین دلیل، هرچه داده در لایههای بیشتری پردازش شود، مدل میتواند ویژگیها و روابط سطح بالاتری را یاد بگیرد.
برای مثال، فرض کنید هدف یک مدل، تشخیص تصویر سگ باشد. در لایههای ابتدایی شبکه ممکن است الگوهای سادهای مانند لبهها و شکلها شناسایی شوند. در لایههای بعدی، این الگوها میتوانند برای تشخیص اجزای پیچیدهتر تصویر و در نهایت شناسایی یک شی مانند سگ به کار گرفته شوند. مدل این الگوها را بهصورت دستی از سوی برنامهنویس دریافت نمیکند، بلکه پارامترهای شبکه را در فرایند آموزش و بر اساس دادهها تنظیم میکند.
در یادگیری ماشین سنتی، معمولا بخشی از ویژگیهای مورد استفاده برای آموزش مدل باید از قبل مشخص یا استخراج شوند. در یادگیری عمیق، شبکه عصبی میتواند بسیاری از این ویژگیها را مستقیما از دادههای خام یاد بگیرد. البته این فرایند به نوع مسئله و روش یادگیری بستگی دارد و یادگیری عمیق الزاما به معنای یادگیری بدون نظارت نیست. مدلهای یادگیری عمیق میتوانند با روشهایی مانند یادگیری نظارتشده، بدون نظارت و خودنظارتی آموزش ببینند.
فرایند آموزش با ارائه داده به مدل آغاز میشود. مدل بر اساس پارامترهای فعلی خود یک پیشبینی انجام میدهد، سپس میزان خطای پیشبینی با استفاده از یک تابع زیان محاسبه میشود. الگوریتم بهینهسازی با استفاده از این خطا، پارامترهای مدل را بهروزرسانی میکند. این فرایند بارها تکرار میشود تا مدل بتواند الگوهای موجود در دادههای آموزشی را با دقت بیشتری یاد بگیرد.
آموزش مدلهای عمیق، بهویژه در مسائل پیچیده و مجموعهدادههای بزرگ، معمولا به داده و توان پردازشی قابلتوجهی نیاز دارد. پیشرفت سختافزارهایی مانند GPUها و دسترسی به زیرساختهای محاسباتی قدرتمند، نقش مهمی در توسعه و استفاده گسترده از مدلهای یادگیری عمیق داشته است.
شبکههای عصبی یادگیری عمیق
شبکههای عصبی مصنوعی (ANN) پایه بسیاری از مدلهای یادگیری عمیق را تشکیل میدهند. این شبکهها از لایههای ورودی، پنهان و خروجی تشکیل شدهاند و با عبور دادن داده از میان چندین لایه، الگوها و ویژگیهای مختلف را بهصورت مرحلهای یاد میگیرند.
در یادگیری عمیق، معماریهای مختلفی برای پردازش انواع داده و حل مسائل متفاوت به کار میروند. برای مثال، شبکههای عصبی پیچشی (CNN) در پردازش و تحلیل تصاویر کاربرد گستردهای دارند و شبکههای عصبی بازگشتی (RNN) برای دادههای ترتیبی مانند متن و گفتار طراحی شدهاند. در کنار این معماریها، مدلهای جدیدتری مانند شبکههای مبتنی بر Transformer نیز در بسیاری از کاربردهای پردازش زبان، بینایی کامپیوتر و سایر حوزهها استفاده میشوند.
این مدلها با استفاده از دادههای آموزشی و روشهای بهینهسازی، پارامترهای خود را تنظیم میکنند تا بتوانند الگوهای موجود در دادهها را یاد بگیرند. نوع داده و روش آموزش نیز به مسئله بستگی دارد و میتواند شامل یادگیری نظارتشده، بدون نظارت یا خودنظارتی باشد.
معماریها و رویکردهای مهم یادگیری عمیق
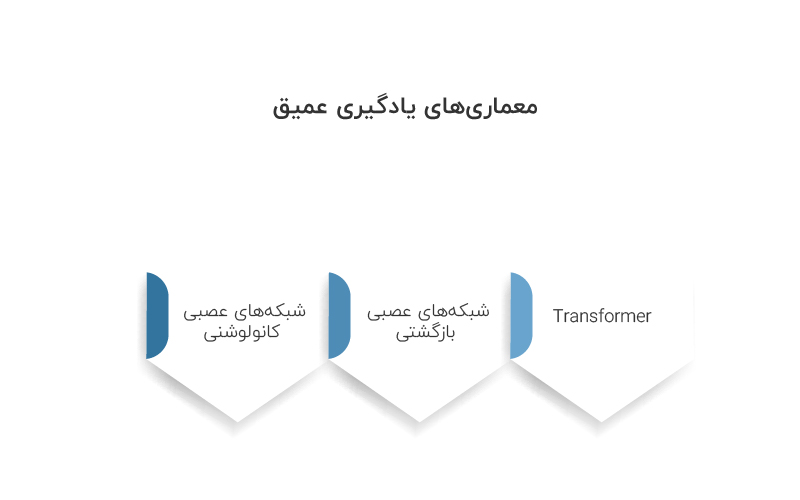
مدلهای یادگیری عمیق از معماریها و روشهای مختلفی برای پردازش انواع داده استفاده میکنند. CNN، RNN و Transformer از معماریهای مهم این حوزه هستند؛ در کنار آنها، روشهایی مانند Attention، مدلهای مولد و یادگیری خودنظارتی نیز نقش مهمی در توسعه مدلهای جدید دارند.
شبکههای عصبی کانولوشنی (CNN)
شبکههای عصبی کانولوشنی (Convolutional Neural Networks) برای پردازش دادههای دارای ساختار مکانی، بهویژه تصاویر، طراحی شدهاند. این شبکهها با استفاده از لایههای کانولوشن میتوانند ویژگیهای مختلف تصویر را از الگوهای ساده مانند لبهها تا ویژگیهای پیچیدهتر استخراج کنند.
CNNها در کاربردهایی مانند طبقهبندی و تشخیص تصویر، تشخیص اشیا و تحلیل تصاویر پزشکی استفاده میشوند. معماریهایی مانند ResNet و DenseNet نیز از نمونههای شناختهشده شبکههای کانولوشنی هستند.
شبکههای عصبی بازگشتی (RNN)
شبکههای عصبی بازگشتی (Recurrent Neural Networks) برای پردازش دادههای ترتیبی طراحی شدهاند و در مسائلی مانند پردازش متن، گفتار و سریهای زمانی کاربرد داشتهاند. این شبکهها اطلاعات مراحل قبلی یک دنباله را در پردازش مراحل بعدی در نظر میگیرند.
LSTM و GRU از معماریهای مبتنی بر RNN هستند که برای مدیریت بهتر وابستگیهای طولانی در دادههای ترتیبی توسعه یافتهاند. با وجود کاربردهای این معماریها، در بسیاری از کاربردهای جدید پردازش زبان، معماری Transformer جایگزین RNNها شده است.
Transformer
Transformer معماریای مبتنی بر سازوکار Attention است که برای پردازش دادههای ترتیبی معرفی شد و بهویژه در پردازش زبان طبیعی به یکی از معماریهای مهم یادگیری عمیق تبدیل شده است. برخلاف RNNها، Transformer برای پردازش وابستگیهای میان بخشهای مختلف ورودی به پردازش ترتیبی مرحلهبهمرحله متکی نیست و در آموزش امکان پردازش موازی دادهها را فراهم میکند.
مدلهای زبانی بزرگی مانند GPT و BERT بر پایه معماری Transformer توسعه یافتهاند. کاربرد Transformer نیز به زبان محدود نمانده و در حوزههایی مانند بینایی ماشین و مدلهای چندوجهی مورد استفاده قرار گرفته است.
مدلهای مولد
مدلهای مولد (Generative Models) برای یادگیری الگوهای موجود در داده و تولید نمونههای جدید طراحی میشوند. GAN یکی از معماریهای شناختهشده در این حوزه است که از دو بخش Generator و Discriminator تشکیل میشود؛ Generator نمونه تولید میکند و Discriminator تلاش میکند نمونه واقعی را از نمونه تولیدشده تشخیص دهد.
مدلهای مولد در کاربردهایی مانند تولید و ویرایش تصویر، افزایش وضوح تصاویر و تولید داده مصنوعی استفاده شدهاند. در سالهای اخیر، معماریها و روشهای دیگری نیز برای تولید متن، تصویر، صوت و سایر انواع داده توسعه یافتهاند.
یادگیری خودنظارتی
یادگیری خودنظارتی (Self-Supervised Learning) یک معماری نیست، بلکه روشی برای آموزش مدل است که در آن مدل میتواند بخشی از سیگنال آموزشی را از خود دادهها دریافت کند و برای آموزش به برچسبگذاری دستی همه دادهها وابسته نباشد.
این روش بهویژه در آموزش مدلهای بزرگ برای پردازش متن، تصویر و دادههای چندوجهی کاربرد دارد و میتواند امکان استفاده موثرتر از مجموعهدادههای بزرگ و بدون برچسب را فراهم کند.
تفاوت یادگیری عمیق (Deep Learning) با یادگیری ماشین (Machine Learning)
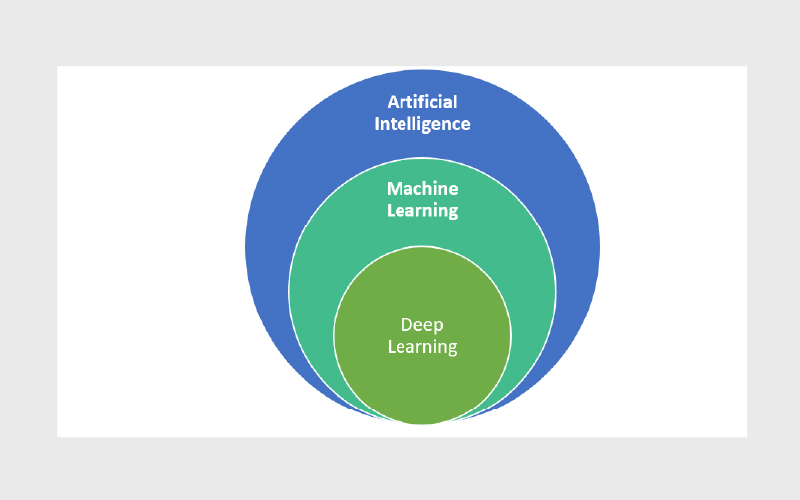
یادگیری عمیق یکی از زیرشاخههای یادگیری ماشین است. تفاوت مهم این دو رویکرد در نحوه یادگیری ویژگیها و نوع مسائلی است که معمولا برای آنها استفاده میشوند. در بسیاری از روشهای یادگیری ماشین، انتخاب یا مهندسی ویژگیها نقش مهمی دارد؛ در حالی که شبکههای عمیق میتوانند بسیاری از ویژگیهای موردنیاز را مستقیما از داده یاد بگیرند.
| شاخص | یادگیری ماشین | یادگیری عمیق |
|---|---|---|
| جایگاه | زیرمجموعهای از هوش مصنوعی | زیرمجموعهای از یادگیری ماشین |
| استخراج ویژگی | معمولاً نیازمند طراحی یا انتخاب ویژگی | قابلیت یادگیری خودکار بسیاری از ویژگیها |
| داده موردنیاز | بسته به مسئله، میتواند با داده کمتری قابل استفاده باشد | در بسیاری از مسائل پیچیده، از داده بیشتر بهره میبرد |
| منابع محاسباتی | معمولاً کمتر | معمولاً بیشتر، بهویژه برای مدلهای بزرگ |
| کاربردهای شاخص | دادههای ساختاریافته و مسائل پیشبینی | تصویر، متن، صدا و دادههای پیچیده |
| مدلهای رایج | درخت تصمیم، SVM، رگرسیون و… | CNN، RNN، Transformer و… |
این تفاوتها مطلق نیستند و انتخاب بین یادگیری ماشین و یادگیری عمیق به نوع داده، مسئله، حجم داده و منابع محاسباتی بستگی دارد.
کاربردهای یادگیری عمیق
یادگیری عمیق امروزه در بسیاری از حوزههایی که با حجم زیادی از دادههای پیچیده سروکار دارند استفاده میشود. پردازش زبان طبیعی (NLP)، بینایی کامپیوتر، تشخیص گفتار، تحلیل تصاویر پزشکی، تولید محتوا و اتوماسیون صنعتی از جمله کاربردهای مهم آن هستند.
برخی از کاربردهای یادگیری عمیق عبارتاند از:
- تجربه مشتری (CX): مدلهای یادگیری عمیق در چتباتها و دستیارهای هوشمند برای درک درخواست کاربران و تولید پاسخ استفاده میشوند و میتوانند به بهبود تجربه مشتری کمک کنند.
- تولید و پردازش متن: مدلهای مبتنی بر یادگیری عمیق میتوانند الگوهای موجود در متن را یاد بگیرند و برای تولید، خلاصهسازی، ترجمه و بازنویسی محتوا به کار گرفته شوند.
- اتوماسیون صنعتی: مدلهای بینایی ماشین میتوانند برای شناسایی اشیا، تشخیص وضعیت تجهیزات و شناسایی موقعیتهای بالقوه خطرناک در محیطهای صنعتی استفاده شوند.
- بینایی کامپیوتر: یادگیری عمیق در تشخیص و طبقهبندی تصاویر، تشخیص اشیا و تقسیمبندی تصاویر کاربرد گستردهای دارد و یکی از مهمترین حوزههای استفاده از شبکههای عصبی عمیق محسوب میشود.
- تشخیص و تحلیل تصاویر پزشکی: مدلهای یادگیری عمیق میتوانند در تحلیل تصاویر پزشکی و شناسایی الگوهای مرتبط با برخی بیماریها به متخصصان کمک کنند. البته استفاده از این مدلها در حوزه پزشکی به اعتبارسنجی و نظارت تخصصی نیاز دارد.
- پردازش گفتار و زبان طبیعی: از یادگیری عمیق در سیستمهای تبدیل گفتار به متن، ترجمه ماشینی، تشخیص گفتار و دستیارهای هوشمند استفاده میشود.
- کاربردهای مالی: در حوزه مالی و بازار سرمایه، مدلهای یادگیری عمیق میتوانند برای تحلیل دادههای مالی، شناسایی الگوها، پردازش متون مالی و پشتیبانی از فرایندهای تصمیمگیری مورد استفاده قرار گیرند.
مزایا و محدودیتهای یادگیری عمیق
یادگیری عمیق در پردازش دادههای پیچیده توانایی بالایی دارد، اما آموزش و استفاده از برخی مدلهای آن به داده، منابع محاسباتی و زیرساخت مناسب نیاز دارد. مهمترین مزایا و محدودیتهای آن را میتوان به شکل زیر خلاصه کرد:
| مزایا | محدودیتها |
|---|---|
| یادگیری خودکار بسیاری از ویژگیها | نیاز بالقوه به داده و منابع محاسباتی زیاد |
| عملکرد مناسب در بسیاری از مسائل پیچیده | تفسیرپذیری دشوارتر در مدلهای پیچیده |
| مناسب برای پردازش تصویر، متن، صدا و سایر دادههای پیچیده | حساسیت به کیفیت و توزیع داده |
| امکان استفاده از Transfer Learning | هزینه آموزش و استقرار برخی مدلهای بزرگ |
میزان این مزایا و محدودیتها به نوع مسئله، داده، معماری مدل و منابع در دسترس بستگی دارد.
ابزارها و فریمورکهای یادگیری عمیق
فریمورکهای یادگیری عمیق، بسیاری از مراحل ساخت، آموزش، ارزیابی و استقرار مدلها را ساده میکنند و امکان استفاده از شتابدهندههای سختافزاری مانند GPU و TPU را فراهم میکنند. انتخاب ابزار به نوع پروژه، معماری مدل، محیط اجرا و نیازهای استقرار بستگی دارد. از مهمترین ابزارهای این حوزه میتوان به PyTorch، TensorFlow، Keras و JAX اشاره کرد.
PyTorch
PyTorch یکی از فریمورکهای پرکاربرد برای توسعه و آموزش مدلهای یادگیری عمیق است و در پژوهش و توسعه مدلهای مختلف هوش مصنوعی استفاده میشود. رابط برنامهنویسی انعطافپذیر و قابلیت اجرای محاسبات روی CPU و GPU، آن را به گزینهای مناسب برای آزمایش و توسعه مدلهای پیچیده تبدیل کرده است.
PyTorch همچنین ابزارهایی برای بهینهسازی و استقرار مدلها در اختیار توسعهدهندگان قرار میدهد؛ برای مثال، قابلیت torch.compile میتواند برای بهینهسازی اجرای مدل استفاده شود.
TensorFlow
TensorFlow یکی از فریمورکهای شناختهشده یادگیری ماشین و یادگیری عمیق است که توسط Google توسعه داده شده است. این فریمورک مجموعهای از ابزارها را برای ساخت، آموزش و استقرار مدلهای یادگیری ماشین فراهم میکند و از اجرای محاسبات روی CPU، GPU و TPU پشتیبانی میکند.
TensorFlow در کنار Keras برای طراحی و آموزش مدلها استفاده میشود و ابزارهای مختلفی برای استقرار مدلها در محیطهای گوناگون در اکوسیستم آن وجود دارد.
Keras
Keras یک API سطحبالا برای توسعه مدلهای یادگیری عمیق است که با هدف سادهتر کردن ساخت و آموزش مدلها طراحی شده است. Keras 3 امکان استفاده از backendهای مختلف، از جمله TensorFlow، JAX و PyTorch را فراهم میکند.
سادگی ساخت مدلها و خوانایی کد باعث شده Keras برای یادگیری مفاهیم یادگیری عمیق، نمونهسازی سریع و توسعه مدلهای مختلف گزینه مناسبی باشد.
JAX
JAX کتابخانهای برای محاسبات عددی و مشتقگیری خودکار است که میتواند محاسبات را روی CPU، GPU و TPU اجرا کند. قابلیتهایی مانند automatic differentiation، کامپایل با XLA و اجرای موازی باعث شدهاند JAX در پژوهشهای مرتبط با مدلهای یادگیری ماشین و محاسبات سنگین کاربرد داشته باشد.
JAX را میتوان در کنار ابزارها و فریمورکهایی مانند Flax برای توسعه مدلهای یادگیری عمیق استفاده کرد.
زبانهای برنامهنویسی در یادگیری عمیق
Python رایجترین زبان برنامهنویسی برای توسعه مدلهای یادگیری عمیق است. سادگی زبان و وجود کتابخانهها و فریمورکهایی مانند PyTorch، TensorFlow و Keras باعث شده بخش بزرگی از فرایند توسعه مدلهای یادگیری عمیق با Python انجام شود.
در برخی پروژهها، زبانهایی مانند C++ نیز برای پیادهسازی بخشهای حساس به عملکرد یا توسعه زیرساختهای یادگیری ماشین استفاده میشوند. زبانهای دیگری مانند R نیز در برخی پروژههای تحلیل داده و یادگیری ماشین کاربرد دارند، اما برای شروع یادگیری عمیق و کار با فریمورکهای اصلی این حوزه، Python انتخاب رایجتری است.
یادگیری عمیق در مدلهای هوش مصنوعی جدید
بخش مهمی از پیشرفتهای اخیر هوش مصنوعی بر پایه یادگیری عمیق و معماری Transformer شکل گرفته است. Transformer با توانایی پردازش روابط میان بخشهای مختلف داده، زمینه توسعه مدلهای بزرگی مانند مدلهای زبانی بزرگ (LLM) را فراهم کرده است.
مدلهای جدیدتر میتوانند علاوه بر متن، دادههایی مانند تصویر، صوت و ویدئو را نیز پردازش کنند و به این ترتیب، مفهوم مدلهای چندوجهی (Multimodal Models) شکل گرفته است. بنابراین میتوان ارتباط میان این مفاهیم را بهصورت کلی چنین در نظر گرفت:
یادگیری عمیق ← Transformer ← مدلهای زبانی بزرگ و مدلهای چندوجهی
جمعبندی
یادگیری عمیق با گسترش کاربردهایی مانند بینایی ماشین، پردازش زبان، تولید محتوا، پزشکی و رباتیک، به یکی از حوزههای مهم هوش مصنوعی تبدیل شده است. توسعه مدلهای چندوجهی، بهینهسازی مدلها و افزایش توان پردازشی، مسیرهای تازهای برای استفاده از این فناوری ایجاد کردهاند.
در کنار این پیشرفتها، چالشهایی مانند نیاز به دادههای باکیفیت، هزینه محاسباتی بالا و سوگیری مدلها همچنان مطرح هستند. به همین دلیل، توسعه یادگیری عمیق علاوه بر افزایش توانایی مدلها، بر کاهش هزینه و بهبود بهرهوری و قابلیت اطمینان آنها نیز تمرکز دارد.
منابع
techtarget.com | ibm.com | geeksforgeeks.org
سوالات متداول
دیپ لرنینگ یک زیرشاخه از یادگیری ماشین است که به طور خاص بر استفاده از شبکههای عصبی عمیق تمرکز دارد. در حالی که یادگیری ماشین بر مجموعه وسیعتری از الگوریتمها متکی است و نیازمند دخالت بیشتری از جانب برنامهنویس برای استخراج ویژگیها و تعریف مدلها است، یادگیری عمیق به صورت خودکار ویژگیهای پیچیدهتری را از دادهها استخراج میکند.
یادگیری عمیق در حوزههایی مانند پردازش تصویر، پردازش زبان طبیعی، تشخیص گفتار، تحلیل دادههای پزشکی، خودروهای هوشمند، سیستمهای پیشنهاددهنده و مدلهای مولد کاربرد دارد.
برای توسعه مدلهای یادگیری عمیق، آشنایی با برنامهنویسی، بهویژه Python، مفید و در بسیاری از پروژهها ضروری است. همچنین آشنایی با مفاهیمی مانند جبر خطی، احتمال و آمار و یادگیری ماشین میتواند در درک بهتر این حوزه کمک کند.


دیدگاهتان را بنویسید