
مدل زبانی (Language Model) یکی از فناوریهای پایه در پردازش زبان طبیعی است که به سیستمهای هوش مصنوعی امکان میدهد الگوهای زبان را یاد بگیرند و بر اساس آنها متن را تحلیل یا تولید کنند. از تکمیل جمله و پیشبینی کلمه بعدی تا پاسخگویی به سوالها و کمک به برنامهنویسی، مدلهای زبانی در بسیاری از ابزارهای هوش مصنوعی به کار میروند.
در این مقاله بررسی میکنیم مدل زبانی چیست، چگونه کار میکند و چه تفاوتی با مدل زبانی بزرگ (LLM) دارد. همچنین با انواع مدلهای زبانی، کاربردها، نمونههای شناختهشده و محدودیتهای آنها آشنا میشویم.
مدل زبانی چیست؟
مدل زبانی نوعی مدل محاسباتی در حوزه هوش مصنوعی است که الگوهای موجود در زبان را از طریق دادههای متنی یاد میگیرد. این مدل با برآورد احتمال توالی کلمات یا توکنها، میتواند در وظایفی مانند پیشبینی کلمه بعدی، تکمیل جمله، تولید متن و تحلیل محتوای زبانی به کار گرفته شود.
مدلهای زبانی از روشهای مختلفی برای یادگیری الگوهای زبان استفاده میکنند. مدلهای سنتی بیشتر بر قواعد زبانی یا روابط آماری میان کلمات تکیه داشتند؛ درحالیکه بسیاری از مدلهای امروزی از شبکههای عصبی عمیق، بهویژه معماری ترنسفورمر (Transformer)، استفاده میکنند. این معماری به مدل کمک میکند روابط میان بخشهای مختلف متن را بررسی کند و با توجه به زمینه موجود، پیشبینیهای مناسبتری انجام دهد.
مدلهای زبانی در پردازش زبان طبیعی نقش مهمی دارند و در کاربردهایی مانند ترجمه، خلاصهسازی، طبقهبندی متن، پاسخگویی به سوالها و تولید محتوا استفاده میشوند. البته همه مدلهای زبانی قابلیت انجام تمام این وظایف را ندارند و عملکرد هر مدل به معماری، روش آموزش و هدف طراحی آن بستگی دارد.
نمونههایی از مدل زبانی در هوش مصنوعی

مدلهای زبانی به عنوان ابزاری قدرتمند ظاهر شدهاند و نحوه تعامل ما با فناوری را متحول کردهاند. در ادامه به نمونههایی از LM در هوش مصنوعی اشاره میکنیم:
- ChatGPT: توسط OpenAI توسعه یافته است و بهعنوان یک مدل زبانی پیشرفته با ۱۷۵ میلیارد پارامتر شناخته میشود. GPT میتواند متنی شبیه انسان تولید کند، ترجمه زبان را انجام دهد و به سوالات پاسخ دهد. این مدل حتی در ساخت موسیقی و ایجاد کد نیز کاربرد دارد.
- BERT: با استفاده از معماری ترانسفورماتور ساخته شده است و در درک زمینه در دادههای متنی استفاده میشود. این مدل در تجزیه و تحلیل احساسات، پاسخ به سوال و ترجمه زبان کاربرد دارد. مدل BERT بهدلیل درک حجم زیادی از متن در پردازش زبان طبیعی تاثیر شگفتی دارد.
- ELMO: المو تعبیههای متنی (حالت برداری از کلمات، جملات یا پاراگرافها) را معرفی کرد و نمایش کلمات را بهطور قابل توجهی بهبود بخشید. ELMO با در نظر گرفتن کلمات و زمینههای اطراف، دقت بالایی در پردازش اطلاعات دارد و زبان انسان را به خوبی درک میکند.
مدل زبانی چگونه کار میکند؟
در بسیاری از مدلهای زبانی مدرن، فرایند آموزش و تولید متن بر پایه پیشبینی توکنها انجام میشود.
۱. تبدیل متن به توکن
مدلهای زبانی متن را مستقیما مانند انسان نمیخوانند. ابتدا متن ورودی به واحدهایی به نام توکن (Token) تقسیم میشود. هر توکن میتواند یک کلمه کامل، بخشی از یک کلمه، نشانه نگارشی یا واحد دیگری از متن باشد. سپس این توکنها به نمایشهای عددی تبدیل میشوند تا مدل بتواند آنها را پردازش کند.
برای مثال، جمله «هوش مصنوعی مفید است» پس از توکنسازی به چند واحد تبدیل میشود. تعداد و مرز این واحدها به روش توکنسازی مدل بستگی دارد و لزوما با تعداد کلمات جمله برابر نیست.
۲. یادگیری الگوهای زبان از دادههای آموزشی
در مرحله آموزش، مدل با حجم زیادی از دادهها روبهرو میشود و پارامترهای خود را بهگونهای تنظیم میکند که وظیفه آموزشی تعریفشده را بهتر انجام دهد. در بسیاری از مدلهای زبانی مولد، این وظیفه پیشبینی توکن بعدی بر اساس توکنهای قبلی است.
برای نمونه، اگر ورودی مدل عبارت «امروز هوا بسیار…» باشد، مدل با توجه به الگوهایی که آموخته است، احتمال توکنهای مختلفی مانند «خوب» یا «سرد» را برآورد میکند. این مثال صرفا نحوه پیشبینی را نشان میدهد؛ پاسخ واقعی به زمینه و آموزش مدل بستگی دارد.
۳. پردازش ارتباط میان توکنها با ترنسفورمر
بسیاری از مدلهای زبانی بزرگ امروزی از معماری ترنسفورمر (Transformer) استفاده میکنند. یکی از اجزای اصلی این معماری، سازوکار توجه (Attention) است که به مدل کمک میکند هنگام پردازش متن، ارتباط میان توکنهای مختلف را محاسبه کند.
برای مثال، در جمله «علی کتاب را به رضا داد، چون او به آن نیاز داشت»، تشخیص ارتباط واژههایی مانند «او» و «آن» با بخشهای قبلی جمله به زمینه وابسته است. سازوکار توجه به مدل کمک میکند روابط مرتبط را در متن در نظر بگیرد؛ هرچند این فرایند به معنای درک زبان به شیوه انسان نیست.
۴. تولید پاسخ یا ادامه متن
وقتی کاربر از مدل میخواهد متنی بنویسد، سوالی را پاسخ دهد یا جملهای را کامل کند، مدل ورودی و دستور ارائهشده را پردازش میکند و بر اساس آموختههایش، توکنهای خروجی را تولید میکند. در مدلهای مولد خودرگرسیو، هر توکن تولیدشده میتواند در پیشبینی توکن بعدی نقش داشته باشد. این فرایند تا رسیدن به نقطه پایان یا محدودیت تعیینشده ادامه پیدا میکند.
برای مثال، هنگام درخواست خلاصهسازی یک گزارش، مدل متن گزارش و دستور خلاصهسازی را در نظر میگیرد و توالی جدیدی از توکنها را تولید میکند که قرار است نکات اصلی گزارش را بیان کند. کیفیت این خروجی به مدل، متن ورودی و نحوه بیان درخواست وابسته است.
باید توجه داشت که همه مدلهای زبانی دقیقا با روش پیشبینی توکن بعدی آموزش نمیبینند. برای مثال، برخی مدلها با پیشبینی توکنهای پنهانشده آموزش داده میشوند و برای وظایفی مانند درک یا طبقهبندی متن به کار میروند. بنابراین، سازوکار بالا بیشتر نحوه عملکرد مدلهای زبانی مولد را توضیح میدهد.
انواع مدل زبانی در هوش مصنوعی
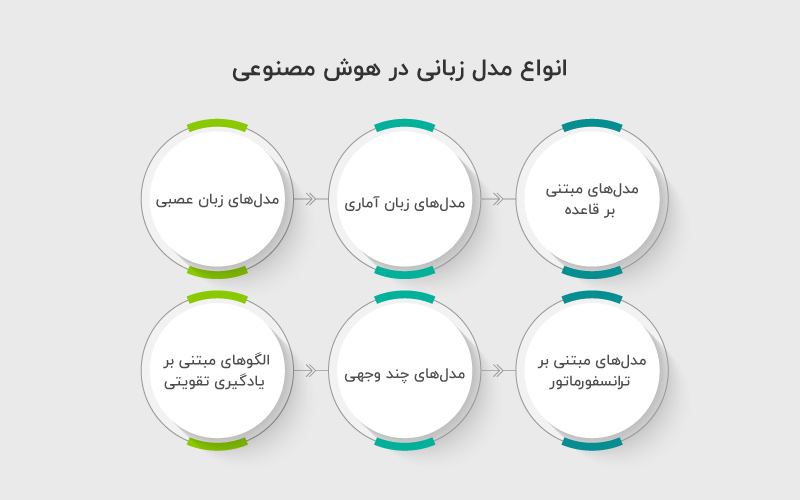
مدلهای زبانی را میتوان بر اساس رویکرد مدلسازی، معماری، مقیاس و نوع دادههایی که پردازش میکنند، دستهبندی کرد. این دستهها الزاما از یکدیگر مستقل نیستند؛ برای مثال، یک مدل زبانی بزرگ میتواند مبتنی بر ترنسفورمر باشد و همزمان قابلیت پردازش متن و تصویر را داشته باشد. در ادامه، مهمترین رویکردها و ویژگیهای مدلهای زبانی را بررسی میکنیم.
۱. مدلهای زبانی سنتی: قاعدهمحور و آماری
مدلهای زبانی سنتی از قواعد زبانی ازپیشتعریفشده یا روشهای آماری برای تحلیل و پیشبینی الگوهای زبان استفاده میکنند. این مدلها پیش از توسعه شبکههای عصبی پیشرفته، در پردازش زبان به کار میرفتند و هرکدام با رویکرد متفاوتی، ساختار و احتمال وقوع کلمات و عبارتها را بررسی میکردند.
مدلهای مبتنی بر قاعده (Rule-Based Models)
در رویکرد قاعدهمحور، سیستم بر اساس مجموعهای از قواعد ازپیشتعریفشده زبانی یا الگوهای مشخص طراحی میشود. این قواعد میتوانند ساختارهای دستوری، الگوهای جملهسازی و شرایط لازم برای تحلیل یا تولید متن را مشخص کنند. چنین سیستمهایی در مسائل محدود و قابلتعریف میتوانند عملکرد قابل پیشبینی داشته باشند، اما معمولا در مواجهه با تنوع زبان، عبارتهای جدید و ساختارهای پیشبینینشده انعطافپذیری کمتری دارند.
مدلهای زبان آماری (Statistical Language Models)
مدلهای زبانی آماری با استفاده از احتمال و فراوانی الگوهای زبانی، احتمال وقوع یک کلمه یا توالی کلمات را برآورد میکنند. مدلهای N-gram نمونهای از این رویکرد هستند که برای تخمین احتمال یک کلمه، تعدادی از کلمات پیشین آن را در نظر میگیرند. این مدلها نسبت به روشهای صرفا قاعدهمحور انعطاف بیشتری دارند، اما در مدلسازی وابستگیهای طولانی متن و مواجهه با توالیهای کمتکرار محدودیتهایی دارند.
۲. مدلهای زبان عصبی (Neural Language Models)
مدلهای زبانی عصبی با استفاده از شبکههای عصبی مصنوعی، الگوها و روابط پیچیدهتری را از دادههای زبانی یاد میگیرند. شبکههای عصبی بازگشتی (RNN) و شبکههای حافظه کوتاهمدت بلند (LSTM) از معماریهایی هستند که برای پردازش توالی دادهها به کار رفتهاند. این معماریها در مقایسه با بسیاری از روشهای سنتی، توانایی بیشتری در یادگیری روابط زبانی داشتند؛ بااینحال، پردازش توالیهای طولانی و آموزش موازی آنها با محدودیتهایی همراه بود. بعدها معماری ترنسفورمر با رویکرد متفاوت خود به یکی از پایههای اصلی توسعه مدلهای زبانی پیشرفته تبدیل شد.
۳. مدلهای مبتنی بر ترانسفورماتور (Transformer-Based Models)
ترنسفورمر (Transformer) معماریای برای پردازش توالی دادههاست که با استفاده از سازوکار توجه (Attention)، روابط میان بخشهای مختلف ورودی را محاسبه میکند. برخلاف معماریهای بازگشتی، ترنسفورمر میتواند بسیاری از محاسبات مربوط به توکنهای ورودی را بهصورت موازی انجام دهد و به همین دلیل، آموزش مدلهای بزرگ را تسهیل کرده است.
بسیاری از مدلهای زبانی پیشرفته امروزی از این معماری استفاده میکنند. برای مثال، مدلهای خانواده GPT برای تولید متن و مدل BERT برای یادگیری بازنماییهای متنی و انجام وظایفی مانند درک و طبقهبندی متن شناخته شدهاند. البته استفاده از ترنسفورمر بهتنهایی تضمینکننده دقت یا کیفیت بالاتر نیست؛ عملکرد مدل به دادههای آموزشی، طراحی و روش آموزش آن نیز بستگی دارد.
۴. مدلهای زبانی کوچک و بزرگ (SLM و LLM)
مدلهای زبانی از نظر مقیاس و ظرفیت نیز با یکدیگر تفاوت دارند. مدلهای زبانی بزرگ (LLM) معمولا با تعداد زیادی پارامتر و حجم گستردهای از دادهها آموزش میبینند و برای انجام طیف متنوعی از وظایف زبانی به کار میروند. در مقابل، مدلهای زبانی کوچک (SLM) معمولا با هدف کاهش هزینه محاسباتی، مصرف حافظه یا امکان اجرا در محیطهای محدودتر طراحی میشوند.
مدلهای کوچکتر ممکن است برای وظایف مشخص، اجرای محلی یا کاربردهایی با محدودیت منابع مناسب باشند؛ درحالیکه مدلهای بزرگتر میتوانند ظرفیت بیشتری برای انجام وظایف متنوع داشته باشند. بااینحال، اندازه مدل بهتنهایی تعیینکننده کیفیت آن نیست و انتخاب میان SLM و LLM به نوع کاربرد، دقت موردنیاز، هزینه و منابع محاسباتی بستگی دارد.
۵. مدلهای چند وجهی (Multimodal Models)
مدلهای زبانی را میتوان بر اساس نوع دادهای که پردازش میکنند و زبانهایی که پشتیبانی میکنند نیز دستهبندی کرد. مدلهای چندزبانه برای کار با چند زبان آموزش میبینند، درحالیکه مدلهای چندوجهی میتوانند اطلاعاتی از جنسهای مختلف، مانند متن، تصویر و صدا را پردازش کنند. البته میزان پشتیبانی از زبانها و انواع داده در هر مدل، به معماری و دادههای آموزشی آن بستگی دارد.
مدلهای چندزبانه (Multilingual Models)
مدلهای چندزبانه برای پردازش یا تولید متن در چند زبان آموزش داده میشوند. این مدلها میتوانند در کاربردهایی مانند ترجمه، تحلیل متن چندزبانه و پاسخگویی به کاربران با زبانهای مختلف به کار روند. البته کیفیت عملکرد آنها ممکن است میان زبانها متفاوت باشد و به میزان و کیفیت دادههای آموزشی هر زبان بستگی دارد.
مدلهای چندوجهی (Multimodal Models)
مدلهای چندوجهی میتوانند اطلاعات را از بیش از یک نوع داده، مانند متن، تصویر یا صوت، پردازش کنند. برای مثال، چنین مدلی ممکن است تصویری را دریافت کند و درباره محتوای آن به سوال کاربر پاسخ دهد. این قابلیتها در کاربردهایی مانند توصیف تصویر، تحلیل محتوای بصری و تعامل صوتی استفاده میشوند.
چندوجهیبودن به این معنا نیست که همه مدلها از تمام انواع داده پشتیبانی میکنند. قابلیتهای ورودی و خروجی هر مدل به طراحی و آموزش آن بستگی دارد.
تفاوت مدل زبانی و مدل زبانی بزرگ چیست؟
مدل زبانی بزرگ (LLM) نوعی مدل زبانی است که معمولا با تعداد زیادی پارامتر و حجم گستردهای از دادههای متنی آموزش داده میشود. تفاوت اصلی این دو اصطلاح در این است که مدل زبانی مفهوم کلیتری است و مدل زبانی بزرگ یکی از انواع آن محسوب میشود.
مدلهای زبانی از نظر اندازه، معماری، دادههای آموزشی و تواناییهایشان با یکدیگر تفاوت دارند. برخی مدلها برای وظایف مشخصی مانند طبقهبندی متن یا تشخیص احساسات طراحی شدهاند؛ در مقابل، مدلهای زبانی بزرگ معمولا میتوانند طیف گستردهتری از وظایف، مانند تولید متن، خلاصهسازی، پاسخگویی به سؤالها و کمک به برنامهنویسی را انجام دهند.
| معیار | مدل زبانی (LM) | مدل زبانی بزرگ (LLM) |
|---|---|---|
| تعریف | اصطلاحی کلی برای مدلسازی الگوهای زبان | مدلی زبانی با مقیاس بزرگ |
| اندازه و پارامترها | میتواند کوچک یا بزرگ باشد | معمولا دارای پارامترهای بیشتر و مقیاس آموزشی بزرگتر است |
| کاربردها | ممکن است برای یک وظیفه مشخص طراحی شده باشد | معمولا برای طیف متنوعی از وظایف زبانی به کار میرود |
| مثال | مدلهای زبانی مبتنی بر N-gram و BERT | مدلهای خانواده GPT و Llama |
البته بزرگتر بودن مدل لزوما به معنای عملکرد بهتر در همه وظایف نیست. انتخاب مدل مناسب به نوع کاربرد، کیفیت پاسخ موردنیاز، هزینه محاسباتی و منابع در دسترس بستگی دارد.
مدلهای زبانی چه کاربردهایی دارند؟
مدلهای زبانی پلی به سوی هوش مصنوعی عمومی هستند و تعامل انسان و ماشین را بهبود میبخشند که به معنای نفوذ پلتفرمهای هوش مصنوعی در صنایع مختلف است. در ادامه به کاربردهای مدل زبانی در هوش مصنوعی اشاره میکنیم:
- گفتوگو و پاسخگویی به کاربران: چتباتها، دستیارهای هوشمند و پشتیبانی مشتریان
- جستوجو و بازیابی اطلاعات: درک پرسش کاربران و کمک به یافتن اطلاعات مرتبط در وب یا اسناد سازمانی
- تولید و ویرایش محتوا: تهیه پیشنویس، بازنویسی، خلاصهسازی و ترجمه متن
- تحلیل دادههای متنی: دستهبندی نظرات مشتریان، تحلیل احساسات و استخراج اطلاعات از اسناد
- آموزش و یادگیری: توضیح مفاهیم، طراحی تمرین و کمک به تولید محتوای آموزشی
- پشتیبانی از فعالیتهای تخصصی: خلاصهسازی متون پزشکی و حقوقی، جستوجو در منابع تخصصی و تهیه پیشنویس اسناد با لزوم بررسی کارشناسی
- شخصیسازی محتوا: تنظیم پاسخها و پیشنهاد محتوا متناسب با نیاز کاربر، با استفاده از اطلاعات مرتبط درباره ترجیحات او
محدودیتها و چالشهای مدلهای زبانی چیست؟
با وجود کاربردهای گسترده، مدلهای زبانی محدودیتهایی دارند که میتوانند بر دقت و قابلاعتماد بودن خروجی آنها تاثیر بگذارند. شناخت این محدودیتها برای استفاده درست از این مدلها ضروری است.
-
تولید اطلاعات نادرست یا توهم مدل (Hallucination): مدلهای زبانی ممکن است اطلاعاتی نادرست، منابع غیرواقعی یا پاسخهایی ظاهرا معتبر اما اشتباه تولید کنند. به همین دلیل، خروجی آنها بهویژه در موضوعات تخصصی باید بررسی شود.
-
سوگیری در دادههای آموزشی: اگر دادههای آموزشی حاوی سوگیری یا بازنمایی نامتوازن گروهها و دیدگاهها باشند، این مسئله ممکن است در پاسخهای مدل نیز منعکس شود.
-
محدودیت در درک زمینه و استدلال: مدل ممکن است در تفسیر دقیق پرسشهای مبهم، حفظ جزئیات در متنهای طولانی یا حل برخی مسائل چندمرحلهای دچار خطا شود. تولید پاسخ روان لزوما به معنای درک کامل موضوع نیست.
-
وابستگی به دادههای آموزشی: دانش مدل به دادههایی که با آنها آموزش دیده و روش بهروزرسانی آن وابسته است. بنابراین، ممکن است از اطلاعات جدید یا رویدادهای اخیر آگاهی نداشته باشد؛ مگر اینکه به منابع بهروز متصل شود.
-
حریم خصوصی و امنیت اطلاعات: وارد کردن اطلاعات محرمانه یا شخصی در برخی سامانههای مدل زبانی میتواند مخاطراتی برای حریم خصوصی ایجاد کند. نحوه نگهداری و استفاده از دادهها به سیاستها و زیرساخت سرویس مورد استفاده بستگی دارد.
-
هزینه محاسباتی و منابع موردنیاز: آموزش و اجرای مدلهای بزرگ ممکن است به توان پردازشی، حافظه و انرژی قابلتوجهی نیاز داشته باشد. این مسئله میتواند هزینه استفاده از آنها را افزایش دهد.
کلام آخر
ظهور ChatGPT باعث شد بحث هوش مصنوعی بیش از گذشته داغ شود. از آنجایی که مدلهای زبانی به رشد خود ادامه میدهند و تسلط خود را به زبان طبیعی بهبود میبخشند، نگرانیهای زیادی در مورد اینکه پیشرفت آنها چه تاثیری بر بازار کار خواهد داشت، وجود دارد. درست است که مدلهای زبانی میتوانند به افزایش بهرهوری و کارایی فرایندها کمک کنند، اما استفاده از آنها باید با ملاحظات انسانی همراه باشد.
منابع
www.elastic.co | www.hpe.com | www.techtarget.com
سوالات متداول
مدل زبانی به مدلی گفته میشود که الگوهای زبان را یاد میگیرد و برای پردازش یا تولید متن به کار میرود. مدل زبانی بزرگ (LLM) نوعی مدل زبانی است که معمولا با پارامترهای بیشتر و حجم گستردهتری از دادهها آموزش میبیند و میتواند وظایف متنوعتری را انجام دهد.
مدلهای زبانی با استفاده از مجموعه دادههای متنی بزرگ و الگوریتمهای یادگیری ماشین آموزش داده میشوند تا بتوانند الگوها و قواعد زبان را یاد بگیرند.
خیر. مدلهای زبانی ممکن است اطلاعات نادرست تولید کنند یا منظور کاربر را بهدرستی تشخیص ندهند. بنابراین، بهویژه هنگام استفاده از آنها در موضوعات تخصصی مانند پزشکی، حقوق و امور مالی، باید پاسخها با منابع معتبر بررسی شوند.


دیدگاهتان را بنویسید