
مدلهای ساخت تصویر با هوش مصنوعی در سالهای اخیر پیشرفت چشمگیری داشتهاند و ابزارهایی مانند Stable Diffusion توانستهاند فرایند تولید تصویر را متحول کنند. در گذشته، معماریهایی مانند GANها بخش مهمی از تولید محتوای تصویری را بر عهده داشتند، اما مشکلاتی مانند ناپایداری آموزش، دشواری کنترل خروجی و محدودیت در کیفیت تصاویر باعث شد نسل جدیدی از مدلها با نام Diffusion Models بهوجود بیایند. Stable Diffusion یکی از مهمترین نمونههای این معماریهاست که با استفاده از فرایند حذف نویز مرحلهبهمرحله، تصاویر بسیار واقعی و باکیفیتی را از روی توضیحات متنی تولید میکند.
در این مقاله بررسی میکنیم Stable Diffusion چیست، چگونه کار میکند و چرا به یکی از مهمترین مدلهای تولید تصویر تبدیل شده است. همچنین با مفاهیمی مانند diffusion process، latent diffusion، نقش U-Net و Text Encoder، نحوه تبدیل prompt به تصویر و استفاده از Stable Diffusion در پایتون آشنا میشویم و کاربردها، مزایا و محدودیتهای این معماری را بررسی خواهیم کرد.
Stable Diffusion چیست؟
Stable Diffusion یک مدل هوش مصنوعی برای تولید تصویر از متن (Text-to-Image Generation) است که با استفاده از معماری diffusion model میتواند بر اساس توضیحات متنی، تصاویر جدید و واقعگرایانه تولید کند. به زبان ساده، کاربر یک prompt متنی وارد میکند و مدل تلاش میکند تصویری متناسب با آن تولید کند.
برای مثال، اگر کاربر متنی مانند:
“A futuristic cyberpunk city at night”
وارد کند، Stable Diffusion میتواند تصویری کاملا جدید بر اساس همین توضیح ایجاد کند؛ بدون اینکه تصویر از قبل وجود داشته باشد.
Stable Diffusion چگونه تصویر تولید میکند؟
برخلاف بسیاری از مدلهای قدیمی تولید تصویر، Stable Diffusion تصویر را مستقیما «نمیکشد». این مدل فرایند تولید تصویر را از نویز تصادفی آغاز میکند و سپس مرحلهبهمرحله نویز را حذف میکند تا در نهایت تصویر نهایی شکل بگیرد.
به همین دلیل، Stable Diffusion در دسته Diffusion Models قرار میگیرد؛ مدلهایی که یاد میگیرند چگونه از داده noisy به تصویر واقعی برسند.
در واقع، مسیر کلی مدل چیزی شبیه این است:
Noise → Denoising → Image
چرا نام آن «Diffusion» است؟
کلمه Diffusion به فرایندی اشاره دارد که در آن داده بهتدریج نویزی میشود و سپس مدل یاد میگیرد این نویز را معکوس کند.
در مرحله آموزش:
- به تصاویر واقعی نویز اضافه میشود
- مدل یاد میگیرد چگونه نویز را حذف کند
- در نتیجه، فرایند بازسازی تصویر را میآموزد
در زمان inference، مدل از نویز خالص شروع میکند و بهمرور تصویر نهایی را میسازد.
همین فرایند تدریجی حذف نویز، هسته اصلی diffusion modelها را تشکیل میدهد.
چرا نام آن «Stable» است؟
واژه Stable به پایداری و کارایی این معماری اشاره دارد. مدلهای diffusion نسبت به بسیاری از معماریهای قدیمیتر مانند GANها معمولا:
- آموزش پایدارتر دارند
- کیفیت تصویر بالاتری تولید میکنند
- کنترلپذیری بیشتری دارند
- در تولید جزئیات عملکرد بهتری ارائه میدهند
علاوه بر این، Stable Diffusion از مفهوم Latent Diffusion استفاده میکند؛ یعنی بهجای پردازش مستقیم تصویر در ابعاد کامل، عملیات diffusion در latent space انجام میشود. این موضوع باعث میشود مدل نسبت به diffusion modelهای اولیه سریعتر و کمهزینهتر باشد.
نقش متن در Stable Diffusion
در Stable Diffusion، متن فقط یک ورودی ساده نیست؛ بلکه راهنمای اصلی فرایند تولید تصویر محسوب میشود. مدل ابتدا prompt متنی را به embedding تبدیل میکند و سپس از آن برای هدایت فرایند حذف نویز استفاده میکند.
به همین دلیل، کیفیت و نوع prompt میتواند تاثیر زیادی روی خروجی نهایی داشته باشد.
در واقع Stable Diffusion تلاش میکند ارتباط میان زبان طبیعی و ویژگیهای بصری را یاد بگیرد تا بتواند تصویر متناسب با توضیح کاربر تولید کند.
چرا Diffusion Models جایگزین مهمی برای GANها شدند؟
قبل از ظهور Diffusion modelها، بخش زیادی از پیشرفتهای تولید تصویر با هوش مصنوعی به معماریهای GAN وابسته بود. مدلهای GAN یا Generative Adversarial Networks توانستند کیفیت تولید تصویر را نسبت به بسیاری از روشهای قدیمیتر بهبود دهند و نقش مهمی در رشد Generative AI داشته باشند. با این حال، این معماریها محدودیتهایی داشتند که بهمرور باعث شد پژوهشگران بهدنبال رویکردهای جدیدتری بروند.
مشکلات GANها
یکی از مهمترین مشکلات GANها، ناپایداری در فرایند آموزش بود. در GAN، دو شبکه مختلف — Generator و Discriminator — باید همزمان با یکدیگر رقابت کنند. همین رقابت باعث میشد training همیشه پایدار نباشد و تنظیم مدل دشوار شود.
علاوه بر این، GANها با مشکلی به نام Mode Collapse هم مواجه بودند. در این حالت، مدل بهجای تولید خروجیهای متنوع، فقط روی تعداد محدودی الگو تمرکز میکند و تنوع تصاویر کاهش پیدا میکند.
از طرف دیگر، آموزش GANها معمولا پیچیده و حساس بود. تغییر hyperparameterها یا معماری میتوانست بهراحتی کیفیت خروجی را تحتتاثیر قرار دهد و رسیدن به عملکرد پایدار نیازمند تنظیمات دقیق بود.
مهمترین محدودیتهای GANها:
- ناپایداری در آموزش
- مشکل mode collapse
- دشواری بهینهسازی
- کنترلپذیری محدودتر روی خروجی
- حساسیت بالا به تنظیمات مدل
ورود Diffusion Models
برای حل این محدودیتها، معماریهای diffusion بهعنوان نسل جدید مدلهای تولیدی معرفی شدند.
برخلاف GANها که تصویر را بهصورت مستقیم تولید میکردند، diffusion modelها از یک فرایند تدریجی استفاده میکنند:
۱. اضافه کردن نویز به تصویر
۲. یادگیری حذف نویز
۳. بازسازی تصویر از داده noisy
در زمان inference، مدل از نویز تصادفی شروع میکند و مرحلهبهمرحله تصویر نهایی را میسازد.
این رویکرد باعث شد فرایند تولید تصویر پایدارتر و قابل کنترلتر شود.
چرا Diffusion Models مهم شدند؟
مهمترین دلیل موفقیت diffusion modelها، کیفیت بالای تصاویر تولیدشده بود. مدلهایی مانند Stable Diffusion توانستند تصاویر بسیار واقعی، باجزئیات و متنوعی تولید کنند که در بسیاری از موارد از خروجی GANها بهتر بود.
علاوه بر کیفیت، diffusion modelها معمولا:
- training پایدارتر دارند
- تنوع خروجی بیشتری تولید میکنند
- کنترلپذیری بهتری روی generation ارائه میدهند
- بهتر با پرامپتهای متنی ترکیب میشوند
همین ویژگیها باعث شد diffusion modelها به معماری اصلی بسیاری از سیستمهای مدرن AI image generation تبدیل شوند.
نقش Stable Diffusion در محبوب شدن Diffusion Models
اگرچه diffusion modelها قبل از Stable Diffusion هم وجود داشتند، اما Stable Diffusion نقش مهمی در محبوبسازی این معماری داشت.
دلیل اصلی این موضوع:
- open-source بودن
- نیاز محاسباتی کمتر نسبت به مدلهای بزرگتر
- استفاده از Latent Diffusion
- دسترسی سادهتر برای دولوپرها بود.
Stable Diffusion نشان داد که diffusion modelها فقط پروژههای تحقیقاتی نیستند، بلکه میتوانند به ابزارهای واقعی و گسترده برای تولید تصویر تبدیل شوند.
Stable Diffusion چگونه کار میکند؟
هسته اصلی Stable Diffusion بر پایه diffusion modelها ساخته شده است؛ مدلهایی که یاد میگیرند چگونه از نویز تصادفی، تصویر واقعی تولید کنند. برخلاف بسیاری از معماریهای قدیمیتر که تصویر را مستقیما generate میکردند، Stable Diffusion تصویر را مرحلهبهمرحله و از طریق فرایند حذف نویز میسازد.
در این معماری، متن، latent space، U-Net و diffusion process همگی با یکدیگر همکاری میکنند تا prompt متنی به تصویر نهایی تبدیل شود.
۱. Diffusion Process
مهمترین ایده در diffusion modelها بسیار ساده است:
اضافه کردن noise و سپس یادگیری حذف noise
در مرحله آموزش، به تصاویر واقعی بهمرور نویز اضافه میشود تا جایی که تصویر تقریبا به noise خالص تبدیل شود. سپس مدل یاد میگیرد این فرایند را برعکس کند و از داده noisy دوباره تصویر را بازسازی کند.
در زمان تولید تصویر، مدل از noise تصادفی شروع میکند و مرحلهبهمرحله آن را به تصویر نهایی تبدیل میکند.
بهصورت ساده:
Noise → Less Noise → Structured Image → Final Image
همین فرایند تدریجی باعث شده diffusion modelها در تولید تصاویر realistic عملکرد بسیار خوبی داشته باشند.
۲. Latent Diffusion
یکی از مهمترین نوآوریهای Stable Diffusion استفاده از مفهوم Latent Diffusion است.
مدلهای diffusion اولیه مستقیما روی پیکسلهای تصویر کار میکردند که بسیار پرهزینه بود. اما Stable Diffusion بهجای پردازش مستقیم تصویر، ابتدا آن را به فضای فشردهتری به نام latent space تبدیل میکند.
یعنی مدل بهجای کار روی خود تصویر، روی representation فشرده تصویر کار میکند.
این رویکرد چند مزیت مهم دارد:
- سرعت بیشتر
- مصرف حافظه کمتر
- هزینه محاسباتی پایینتر
- امکان اجرای مدل روی GPUهای معمولیتر
به همین دلیل Stable Diffusion نسبت به diffusion modelهای اولیه بسیار کاربردیتر شد.
۳. Text Encoder
در Stable Diffusion، متن نقش راهنمای اصلی فرایند تولید تصویر را دارد.
مدل ابتدا prompt متنی را با استفاده از encoder مبتنی بر CLIP به embedding تبدیل میکند.
برای مثال:
“A futuristic cyberpunk city”
به representation عددی تبدیل میشود تا مدل مفهوم آن را درک کند.
سپس این embedding در تمام مراحل generation به مدل کمک میکند تا تصویر با متن هماهنگ باقی بماند. به این فرایند Prompt Conditioning گفته میشود.
۴. U-Net
U-Net مهمترین بخش عملیاتی Stable Diffusion محسوب میشود و هسته فرایند denoising را بر عهده دارد.
وظیفه U-Net این است که در هر مرحله تشخیص دهد:
چه مقدار از تصویر فعلی نویز است و باید حذف شود؟
در هر iteration:
- مدل تصویر noisy را دریافت میکند
- نویز را تخمین میزند
- بخشی از نویز را حذف میکند
- تصویر تمیزتری تولید میشود
این فرایند بارها تکرار میشود تا تصویر نهایی شکل بگیرد. در واقع U-Net مغز اصلی فرایند image generation در Stable Diffusion است.
۵. Denoising Steps
فرایند تولید تصویر در Stable Diffusion کاملا iterative است. مدل تصویر را در یک مرحله تولید نمیکند، بلکه طی چندین denoising step بهتدریج تصویر را میسازد. مسیر کلی چیزی شبیه این است:
Random Noise → coarse shapes → object structure → details → final image
در مراحل اولیه فقط فرم کلی تصویر مشخص میشود، اما در مراحل بعدی جزئیات بیشتری ظاهر میشوند. تعداد stepها میتواند روی کیفیت و سرعت generation تاثیر بگذارد.
۶. VAE (Variational Autoencoder)
برای اینکه Stable Diffusion بتواند در latent space کار کند، از یک Variational Autoencoder یا VAE استفاده میشود.
وظیفه VAE:
- تبدیل تصویر به latent representation
- بازسازی latent به تصویر نهایی
به زبان ساده:
Image → Latent Space → Image
ابتدا تصویر به فضای فشرده latent منتقل میشود و پس از پایان فرایند diffusion، دوباره به تصویر واقعی تبدیل میشود. بدون VAE، استفاده از latent diffusion ممکن نبود.
راهاندازی و استفاده از Stable Diffusion
برای اجرای Stable Diffusion معمولا از کتابخانه Diffusers استفاده میشود. این کتابخانه فرایند بارگذاری مدل و تولید تصویر را سادهتر میکند و تنها با چند خط کد میتوان یک مدل تولید تصویر را اجرا کرد.
گام اول: نصب کتابخانهها
ابتدا باید کتابخانههای موردنیاز نصب شوند:
|
1 |
pip install diffusers==0.10.2 transformers scipy ftfy accelerate |
در این مثال از نسخه Stable Diffusion v1.4 استفاده میشود، اما نسخههای جدیدتر مانند 1.5 یا 2.1 نیز با تغییرات بسیار کم قابل استفاده هستند.
گام دوم: بارگذاری مدل Stable Diffusion
برای استفاده از مدل، ابتدا باید Pipeline مربوط به Stable Diffusion بارگذاری شود.
|
1 2 3 4 5 |
from diffusers import StableDiffusionPipeline pipe = StableDiffusionPipeline.from_pretrained( “CompVis/stable-diffusion-v1-4” ) |
Pipeline تمام بخشهای موردنیاز برای تولید تصویر از متن را آماده میکند.
اگر GPU در دسترس باشد، بهتر است مدل روی CUDA اجرا شود تا سرعت پردازش افزایش پیدا کند.
|
1 |
pipe.to(“cuda”) |
گام سوم: استفاده از نسخه FP16 برای کاهش مصرف حافظه
مدلهای Stable Diffusion حافظه GPU زیادی مصرف میکنند. اگر کارت گرافیک کمتر از 10 گیگابایت حافظه داشته باشد، بهتر است مدل با دقت Float16 اجرا شود.
|
1 2 3 4 5 6 7 8 |
import torch from diffusers import StableDiffusionPipeline pipe = StableDiffusionPipeline.from_pretrained( “CompVis/stable-diffusion-v1-4”, revision=“fp16”, torch_dtype=torch.float16 ) |
این روش مصرف حافظه را کاهش میدهد و اجرای مدل را روی GPUهای ضعیفتر ممکن میکند.
گام چهارم: تولید تصویر از متن
بعد از بارگذاری مدل، تنها کافی است یک Prompt متنی تعریف شود.
|
1 2 3 |
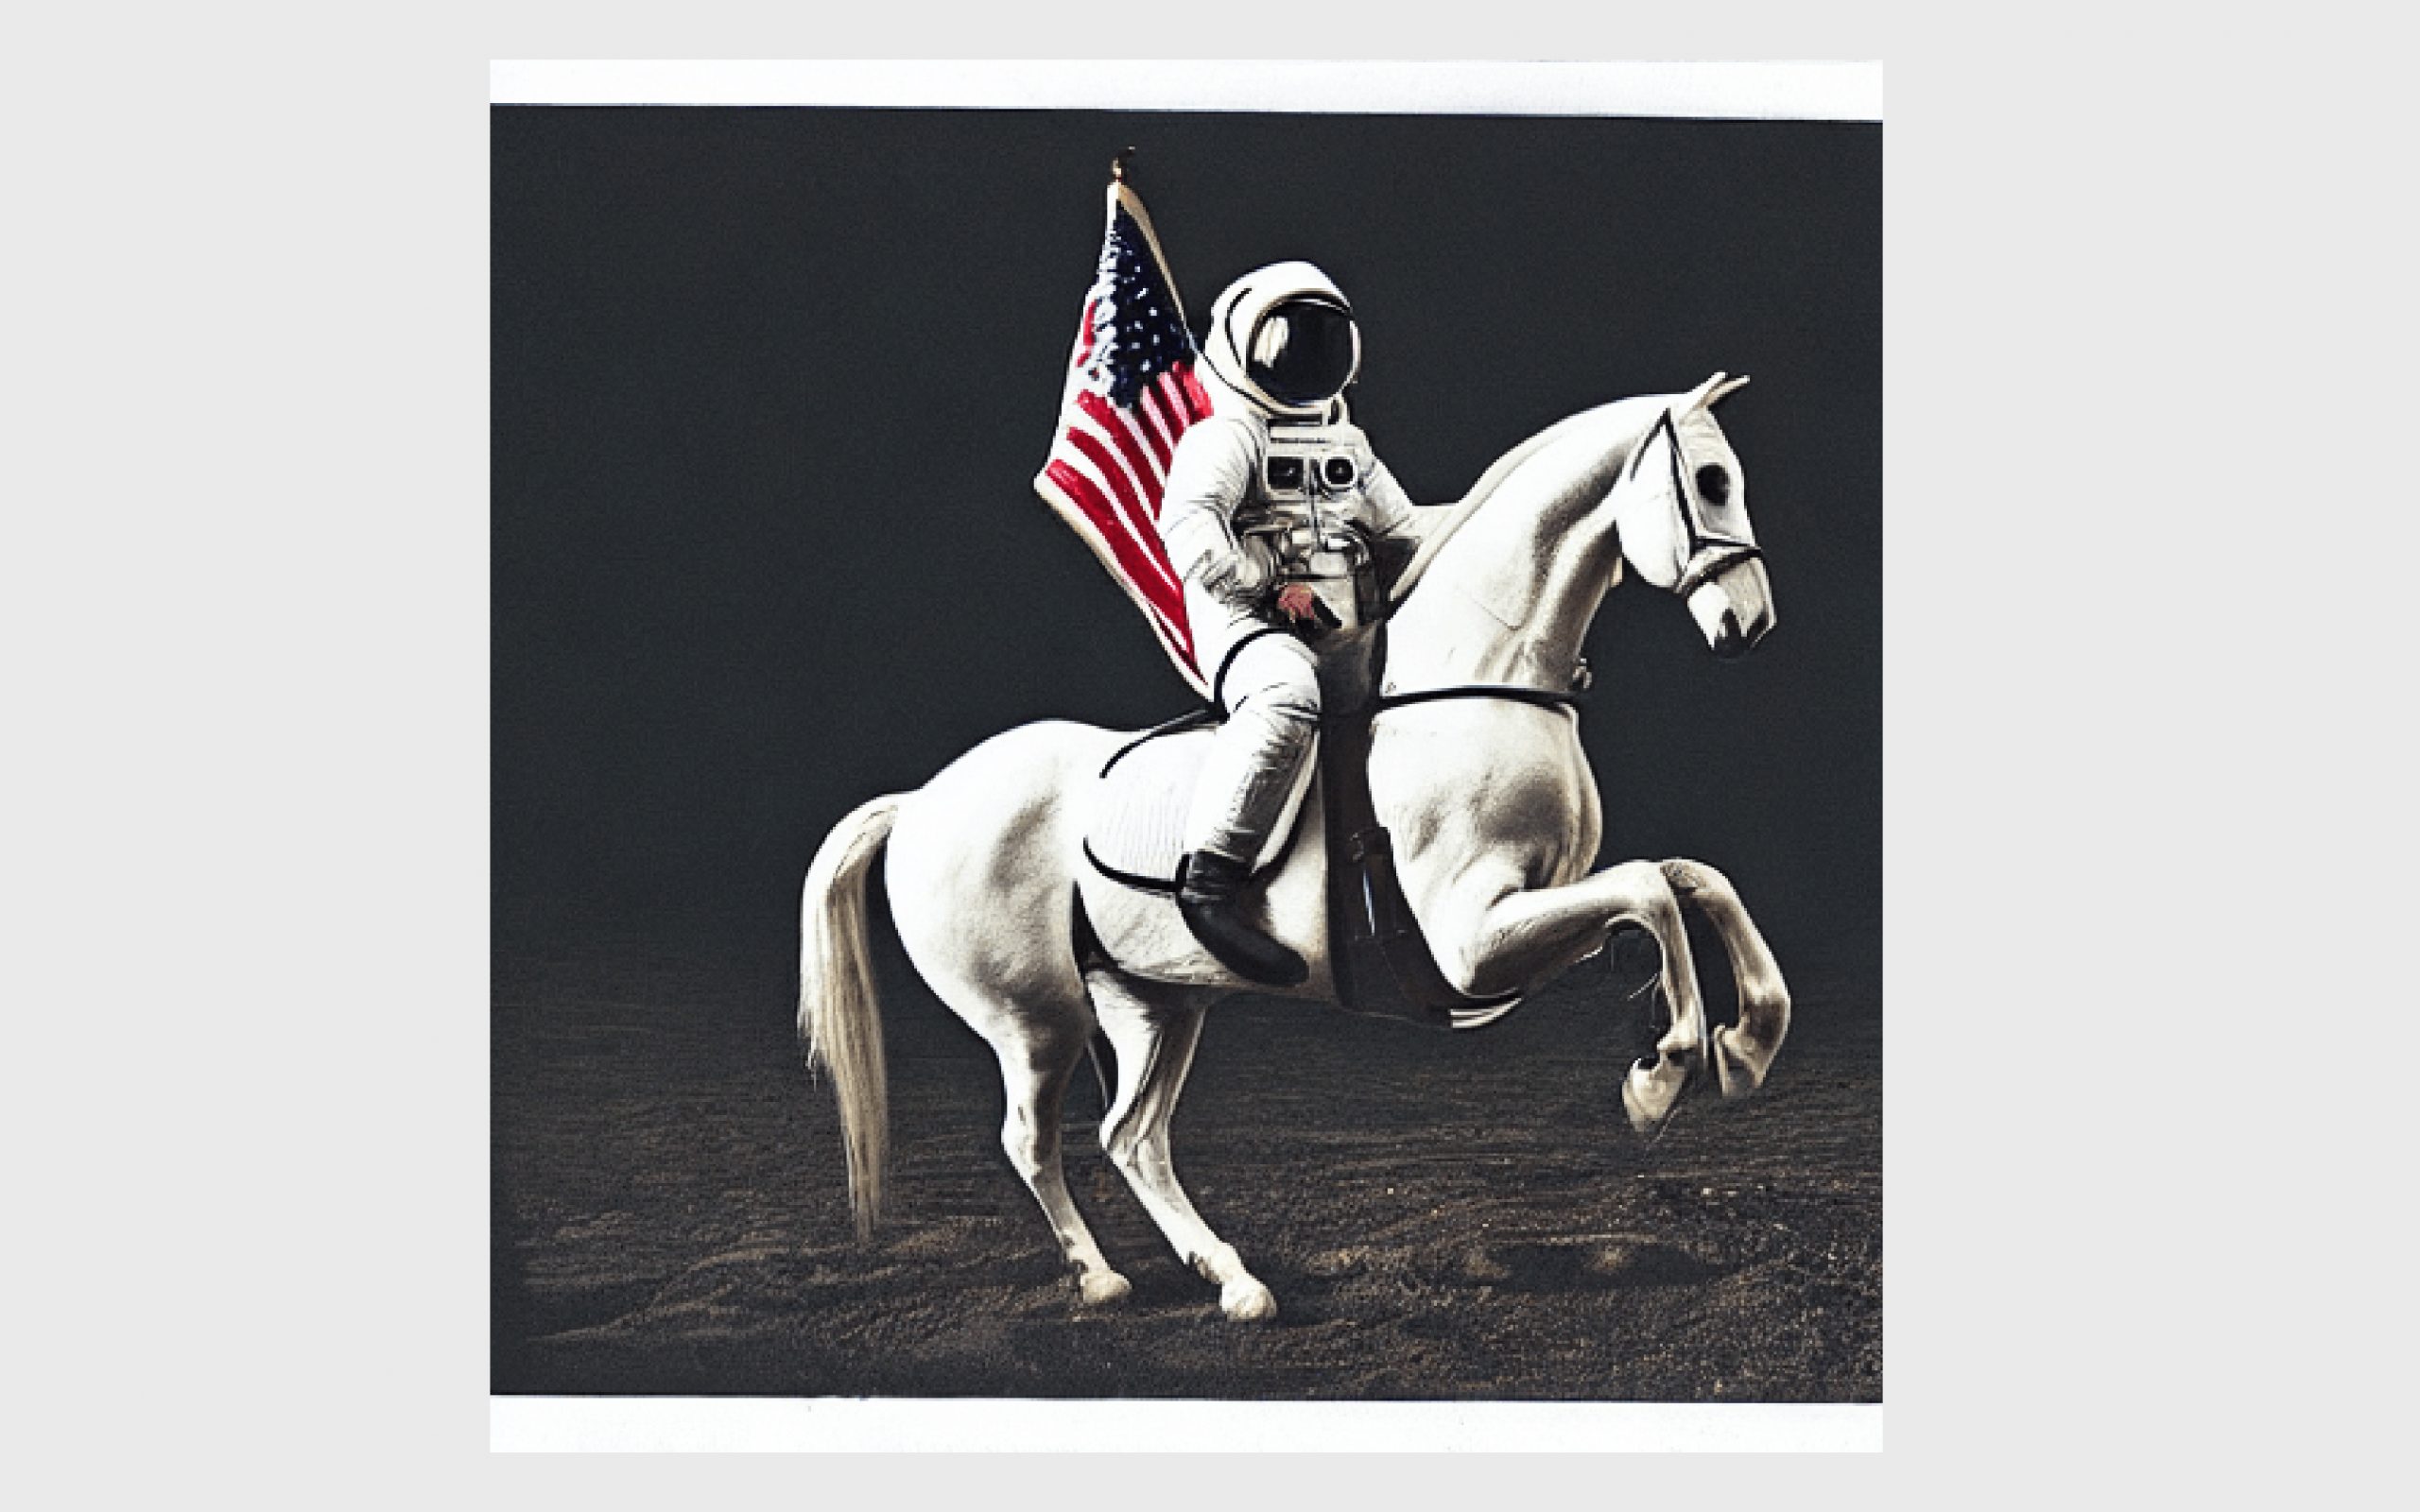
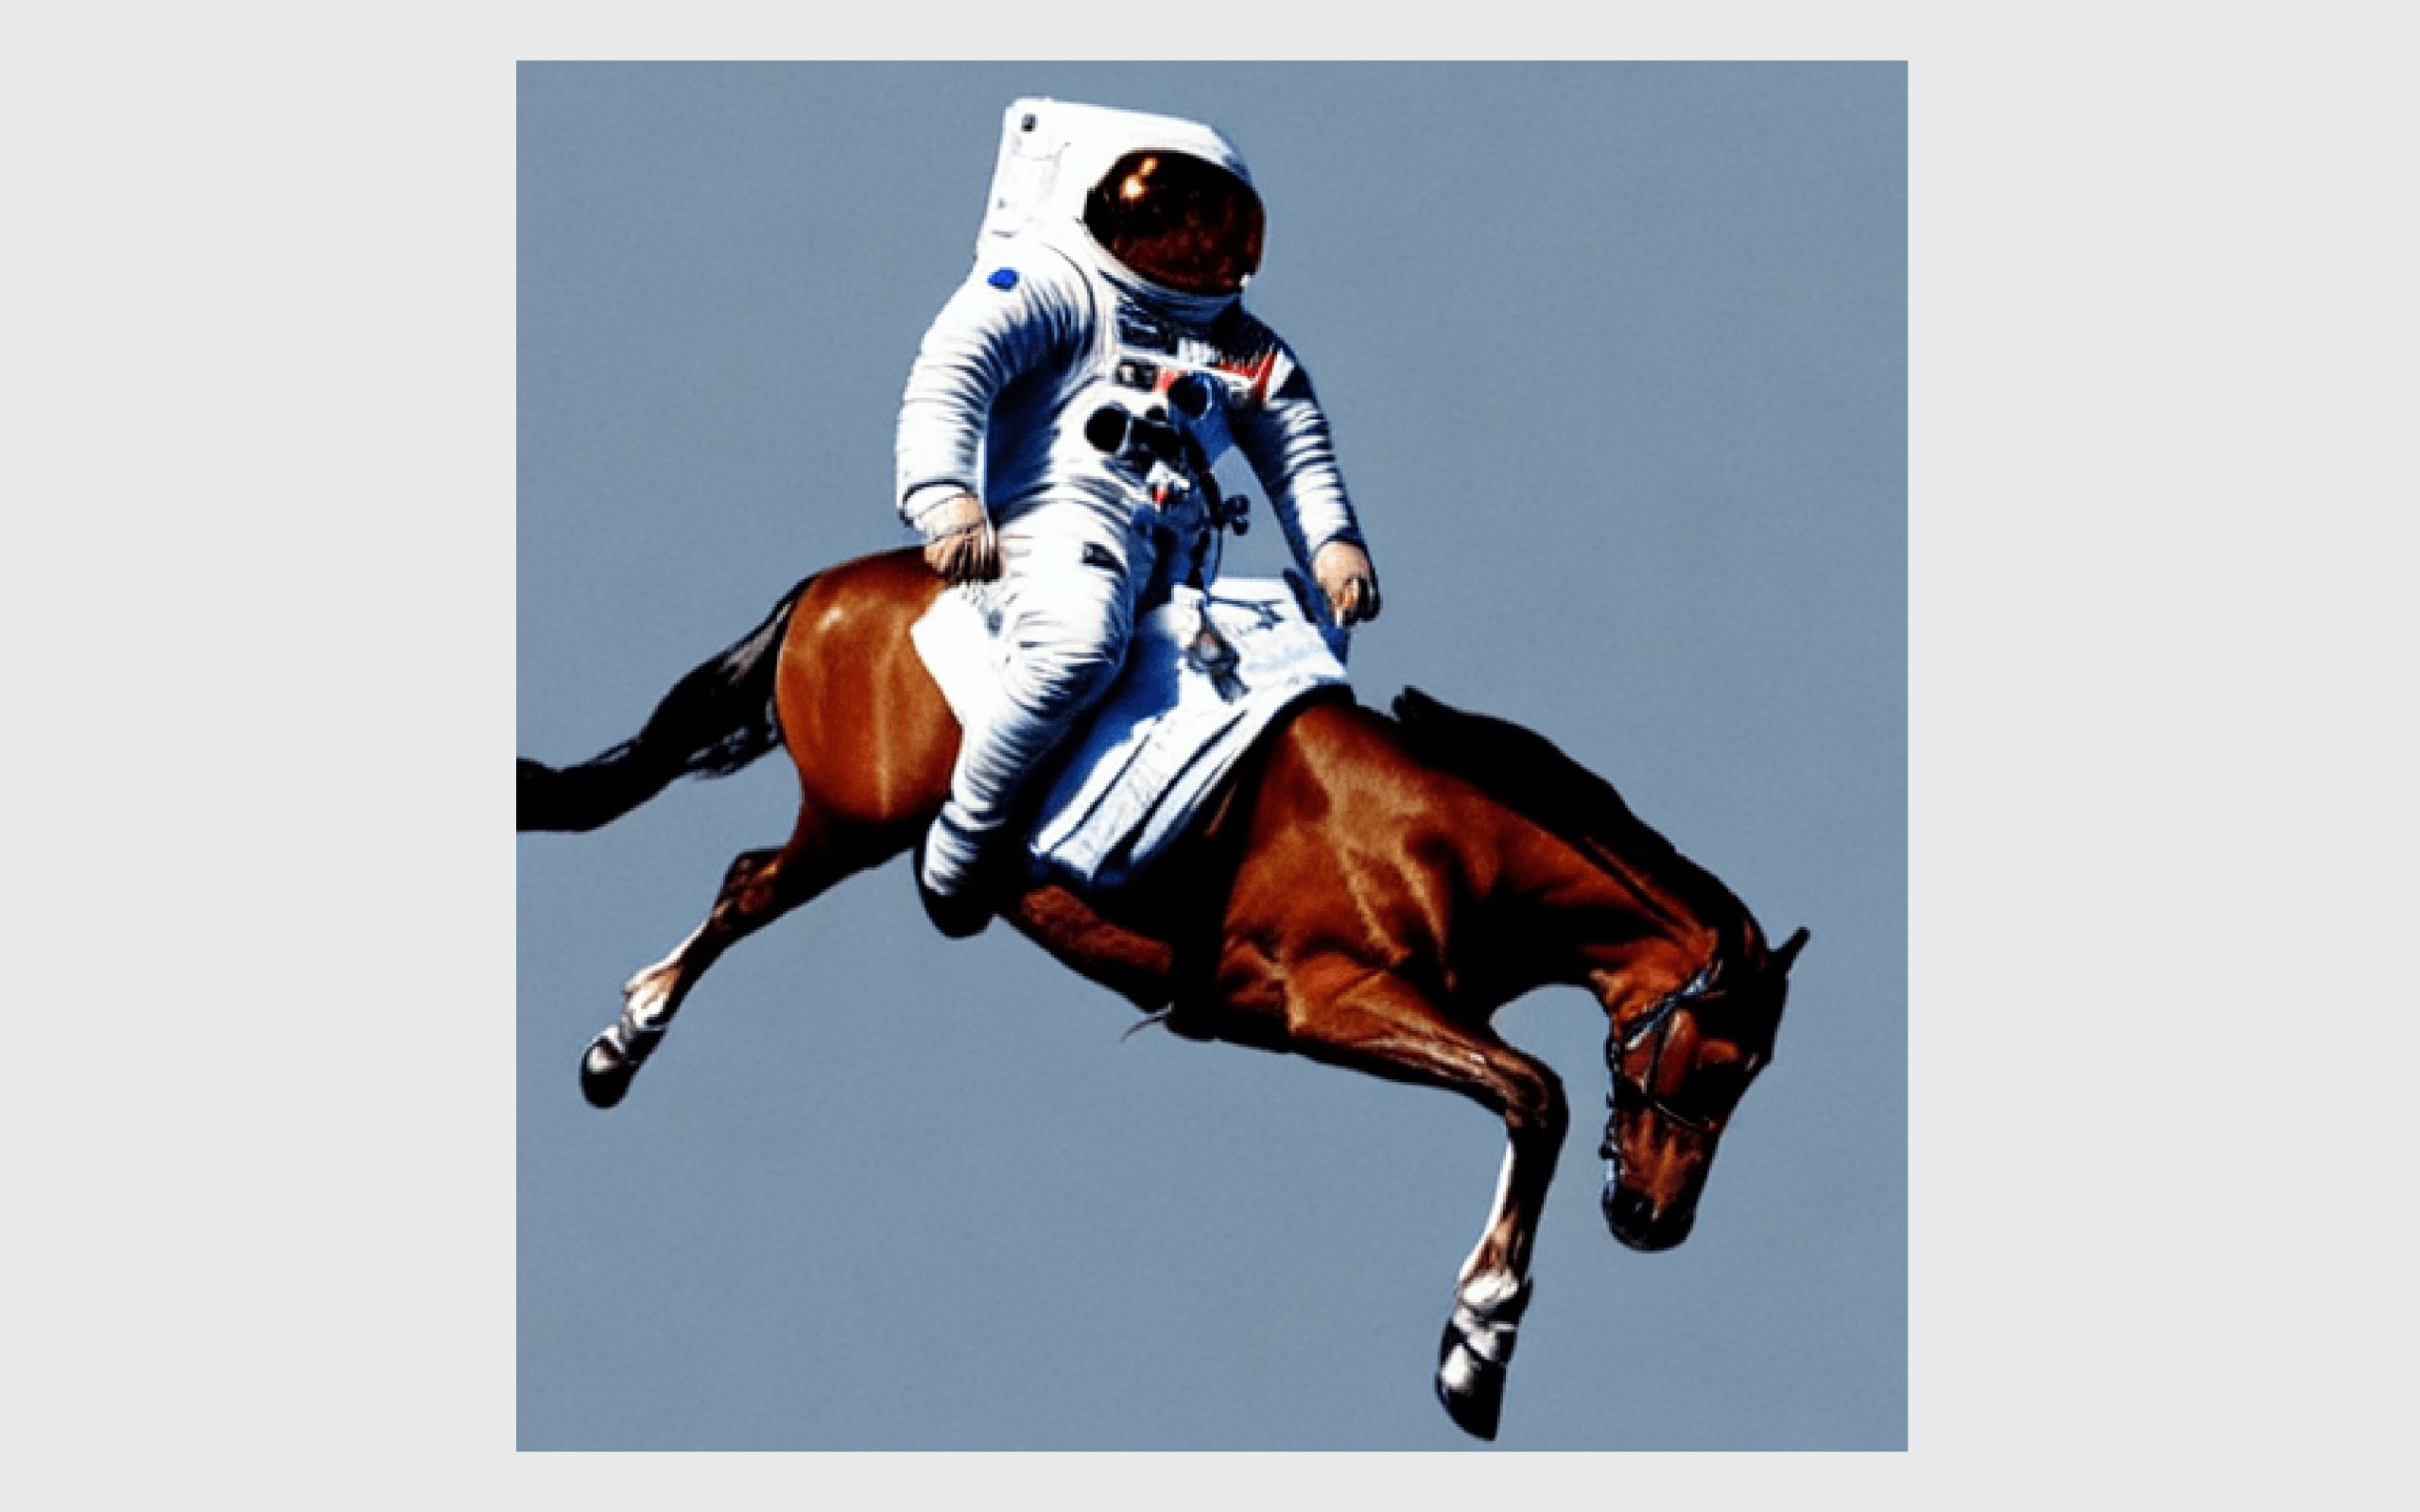
prompt = “a photograph of an astronaut riding a horse” image = pipe(prompt).images[0] |
در این مثال، مدل تصویری از یک فضانورد سوار بر اسب تولید میکند.
گام پنجم: کنترل خروجی با Seed
بهصورت پیشفرض، Stable Diffusion در هر اجرا تصویر متفاوتی تولید میکند. برای تولید خروجی ثابت و قابل تکرار میتوان از Seed استفاده کرد.
|
1 2 3 4 5 6 7 8 9 |
import torch generator = torch.Generator(“cuda”).manual_seed(1024) image = pipe( prompt, guidance_scale=7.5, generator=generator ).images[0] |
در این حالت، با هر بار اجرای کد همان تصویر تولید میشود.
گام ششم: تعداد مراحل تولید تصویر
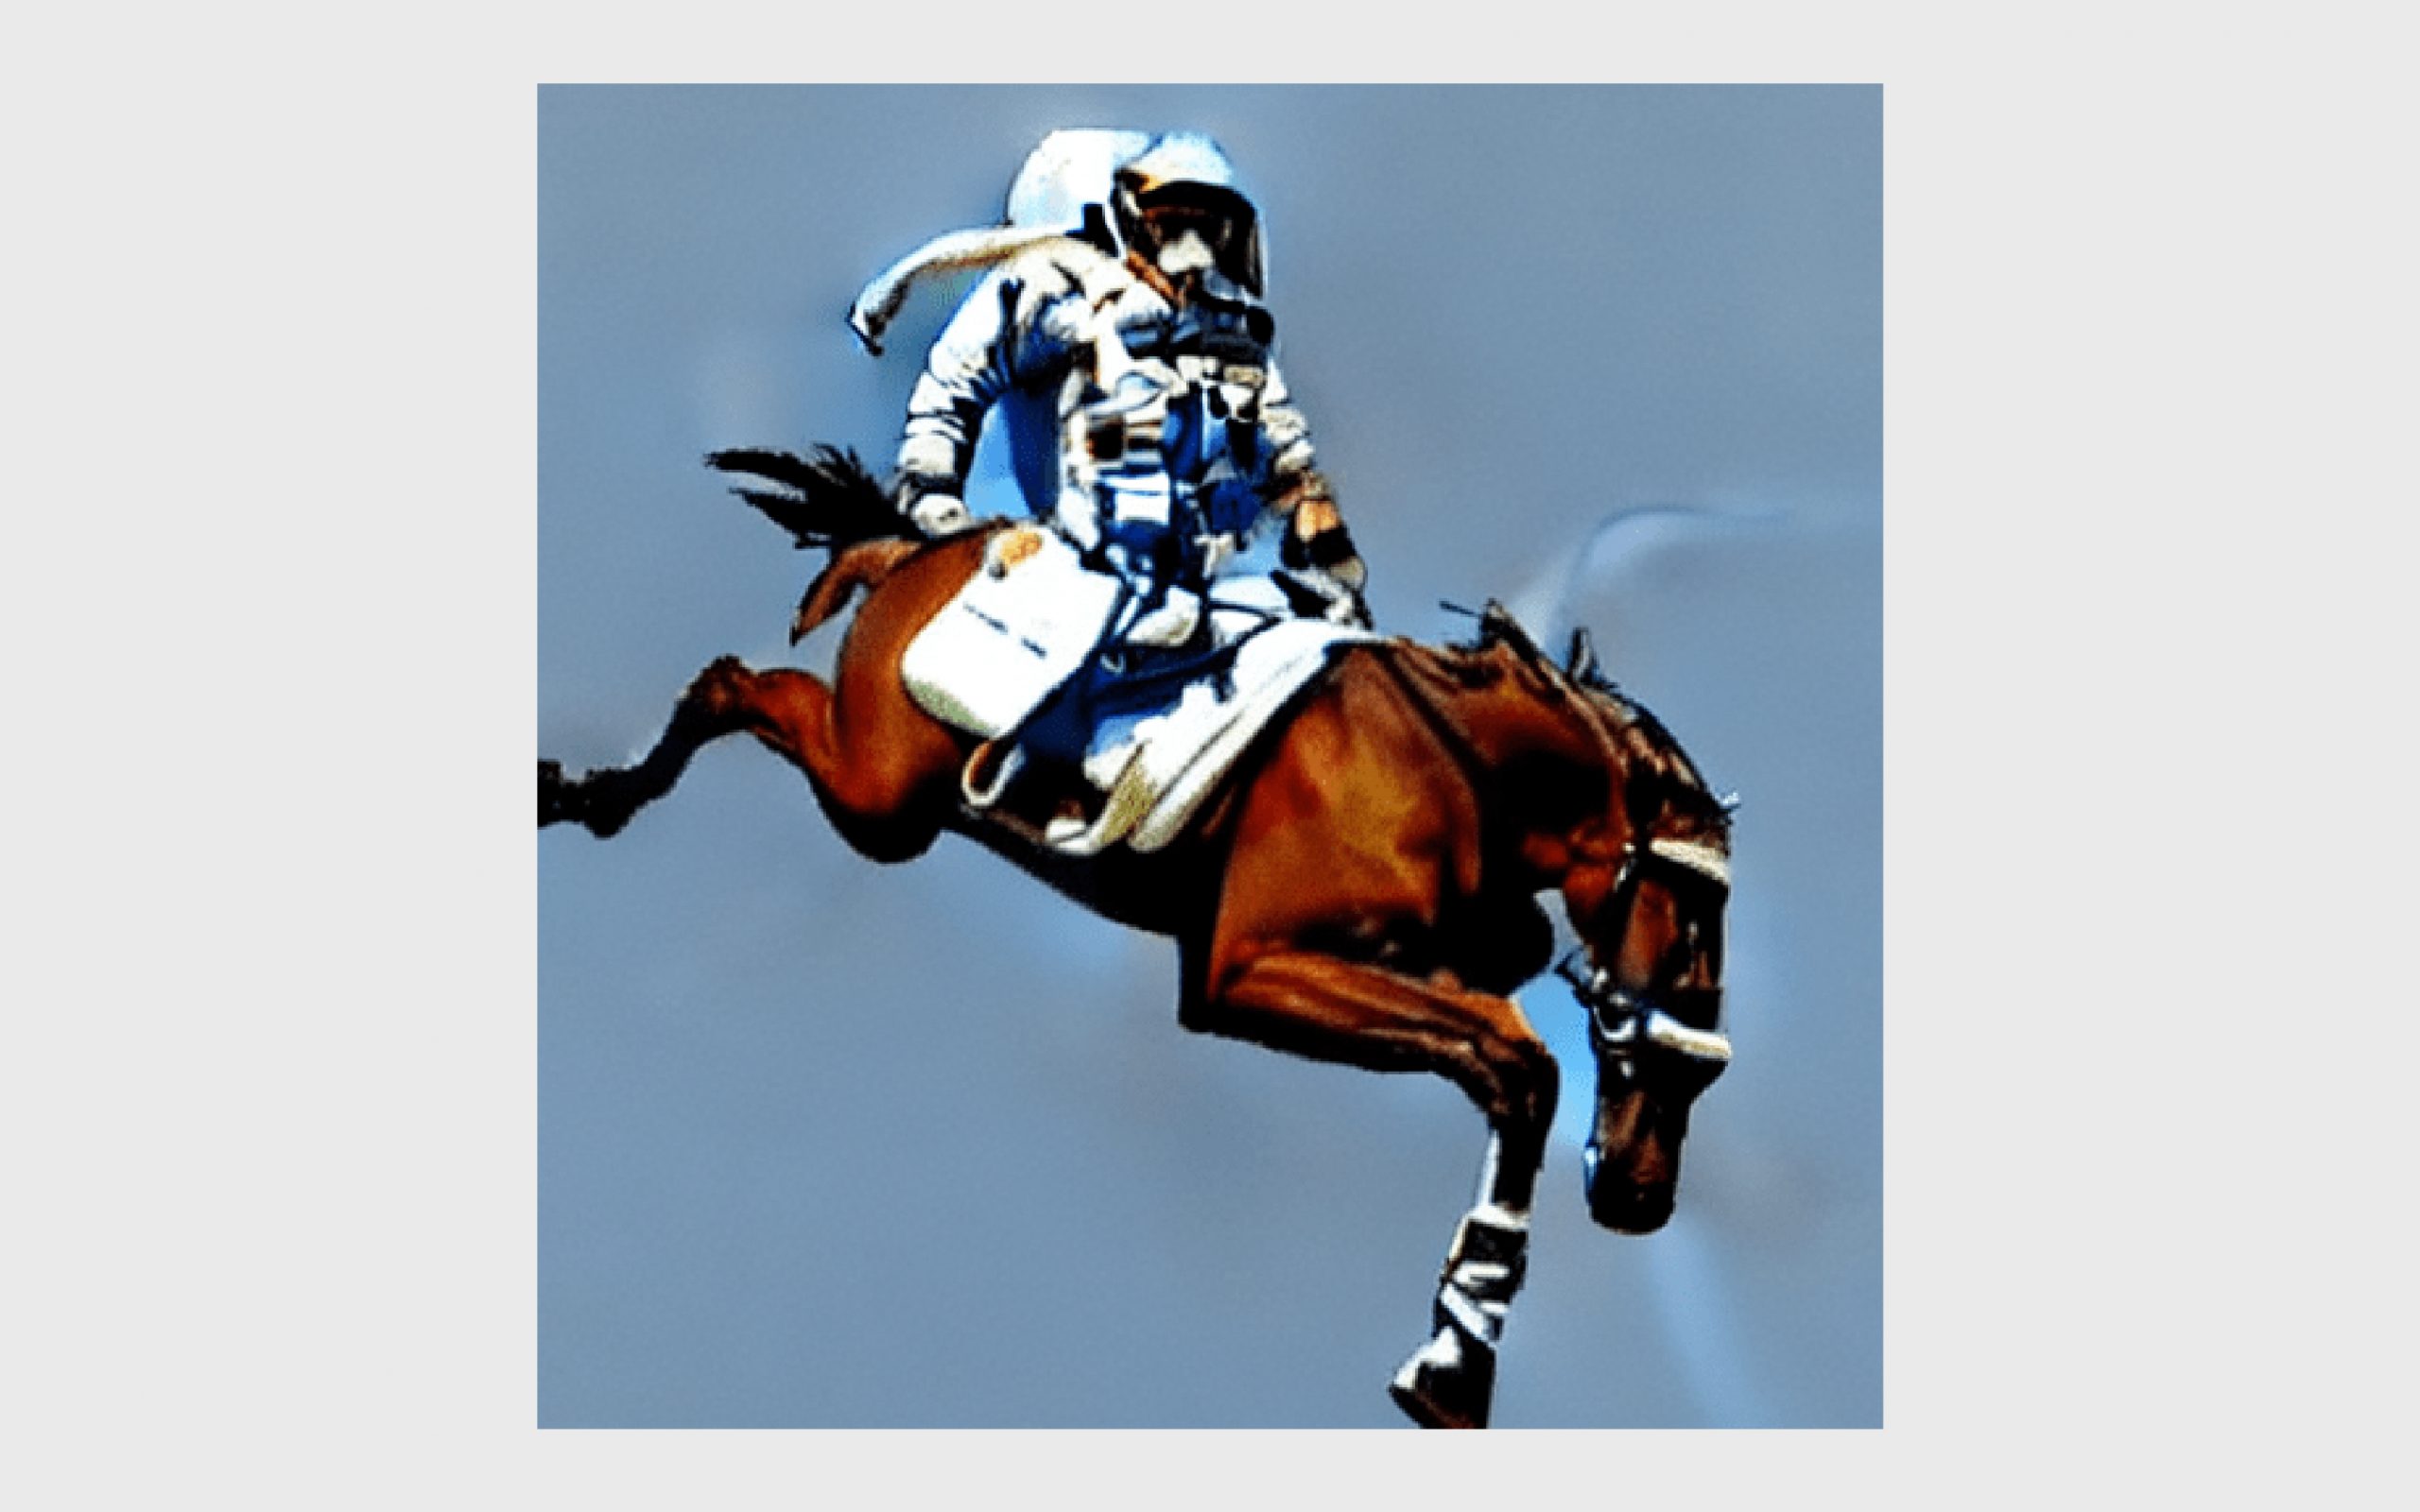
پارامتر num_inference_steps تعداد مراحل حذف نویز را مشخص میکند.
|
1 2 3 4 5 6 |
image = pipe( prompt, guidance_scale=7.5, num_inference_steps=15, generator=generator ).images[0] |
هرچه تعداد مراحل بیشتر باشد، کیفیت تصویر معمولا بهتر خواهد بود؛ اما زمان تولید نیز افزایش پیدا میکند. در بیشتر موارد، مقدار 50 مرحله کیفیت مناسبی ایجاد میکند.
اگر تعداد مراحل خیلی کم باشد، تصویر نهایی ممکن است ناقص یا دارای جزئیات غیرطبیعی شود.
پارامتر Guidance Scale چیست؟
پارامتر guidance_scale مشخص میکند مدل تا چه اندازه به متن ورودی پایبند باشد.
- مقدار کمتر ← تنوع بیشتر تصاویر
- مقدار بیشتر ← تطابق بیشتر با Prompt
معمولا مقادیر بین 7 تا 8.5 برای Stable Diffusion مناسب هستند.
گام هفتم: تولید چند تصویر همزمان
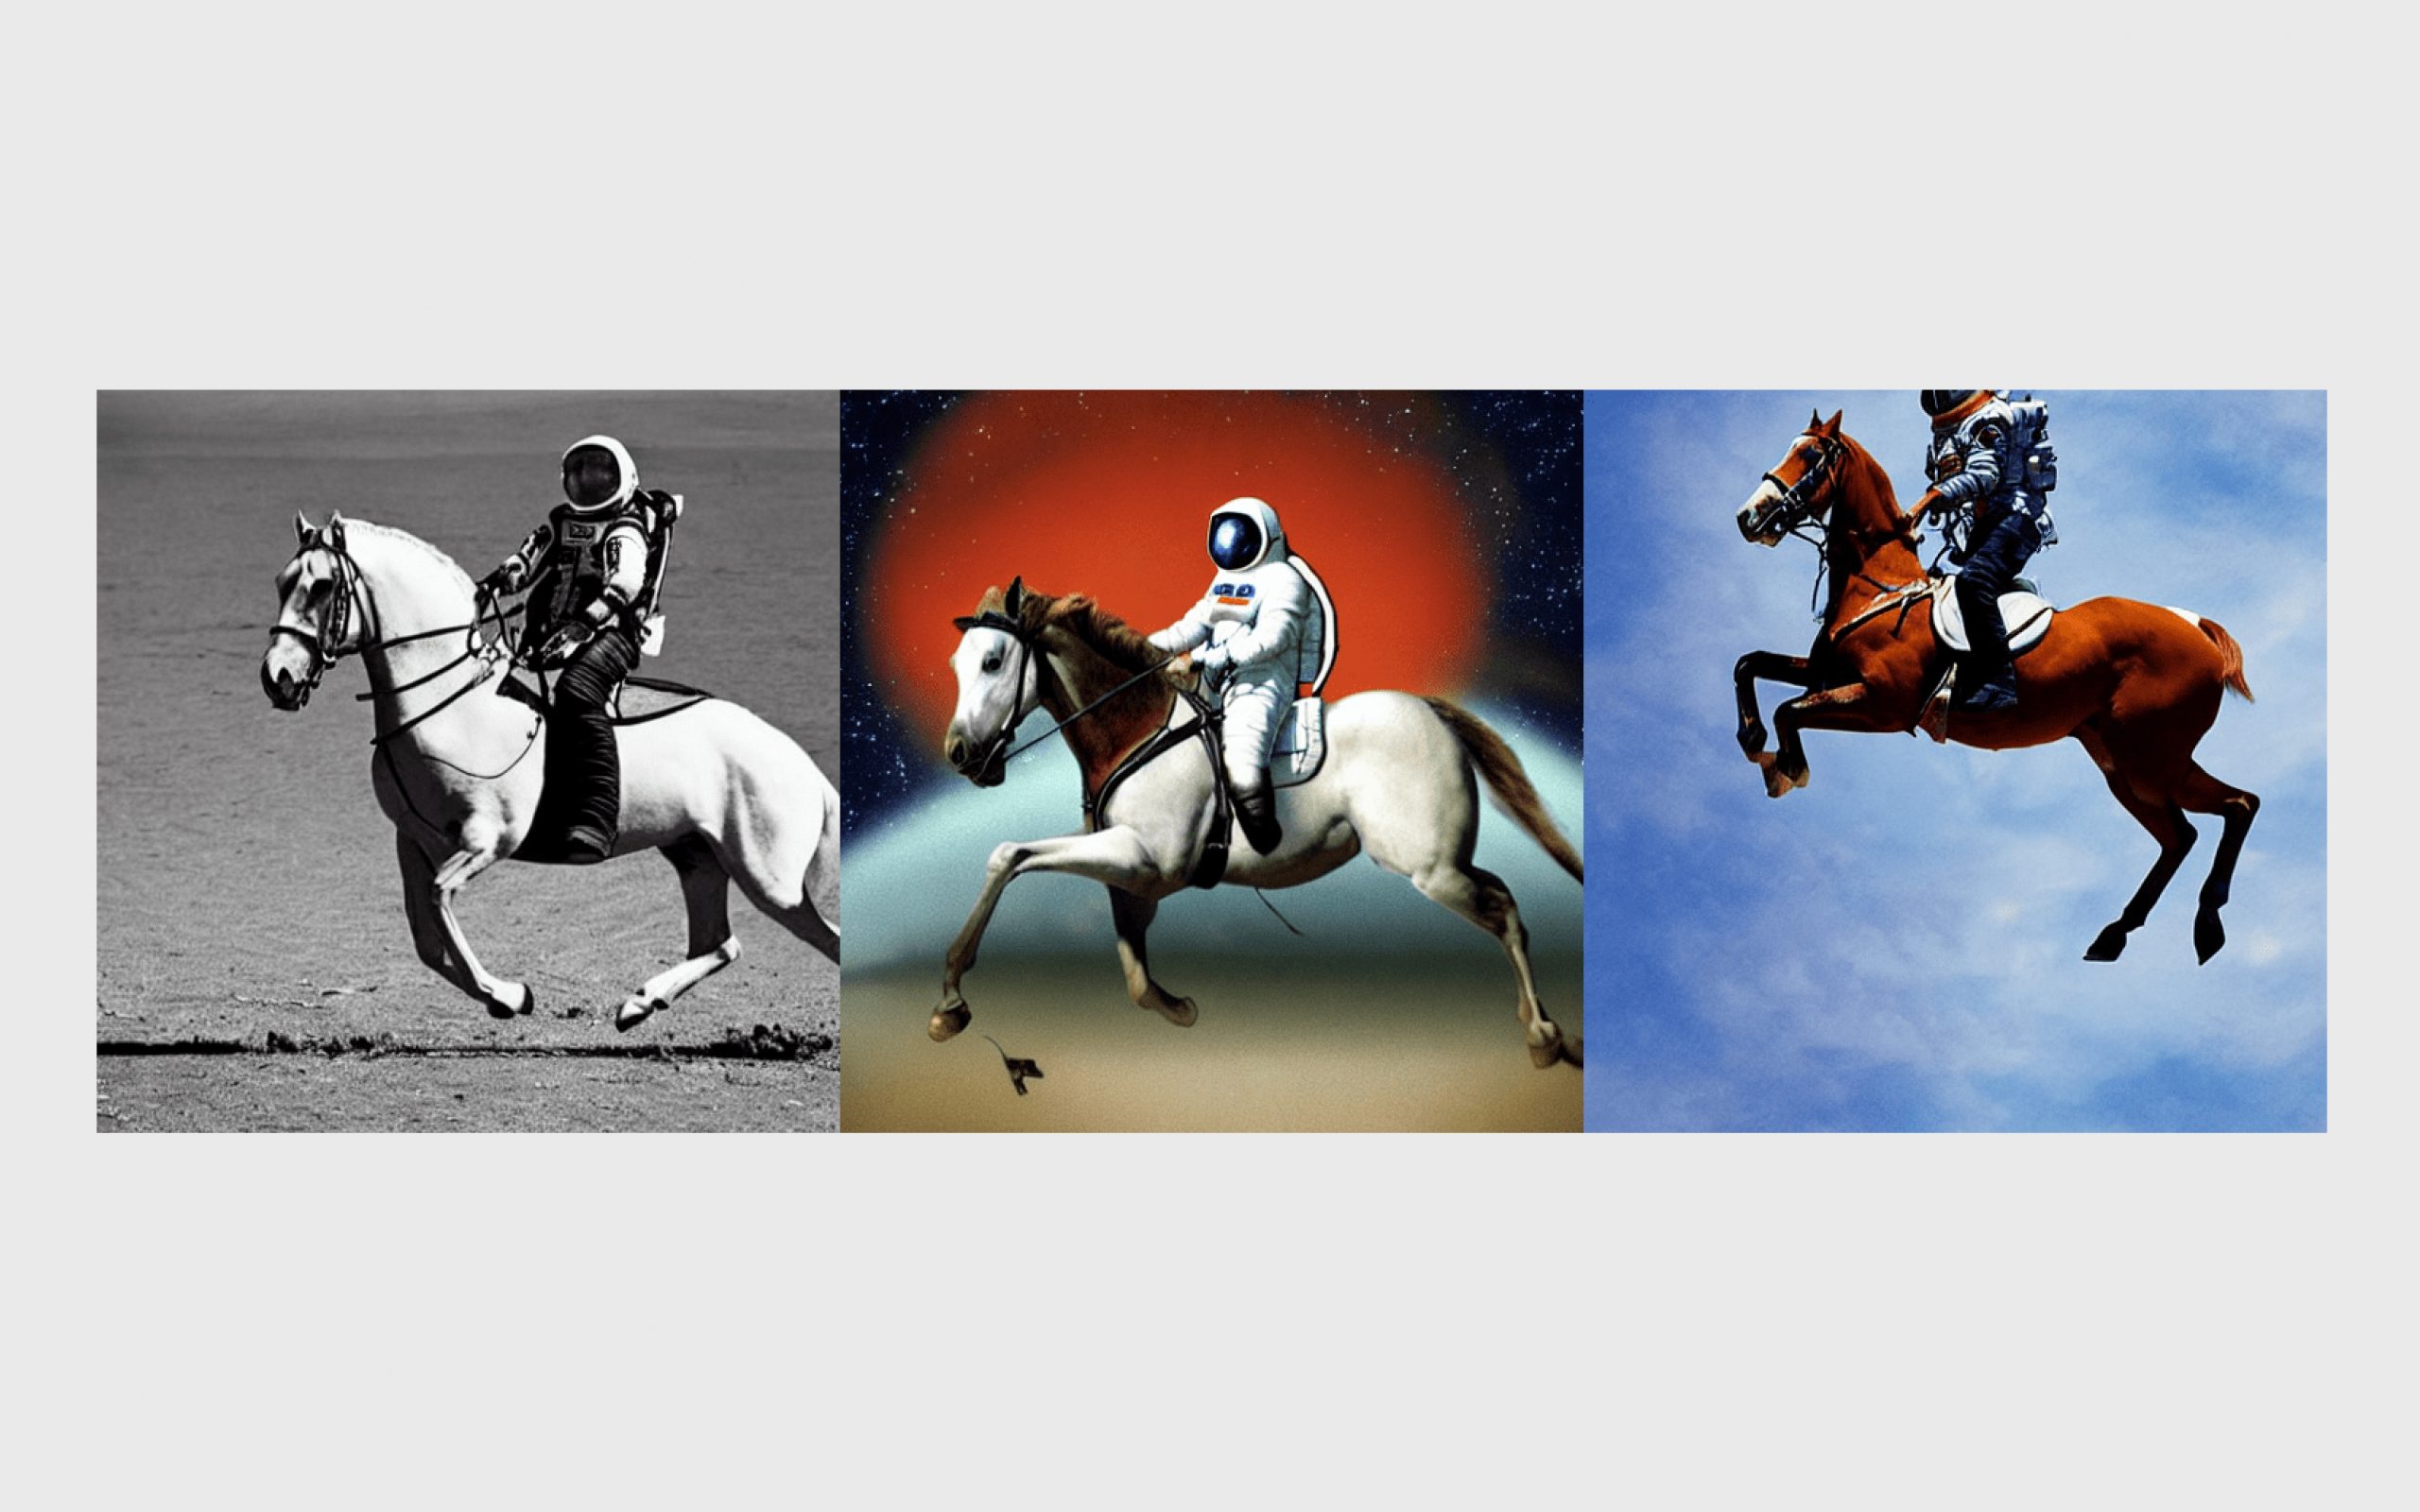
میتوان چند تصویر مختلف را از یک Prompt تولید کرد.
|
1 2 3 4 5 6 7 |
num_images = 3 prompt = [ “a photograph of an astronaut riding a horse” ] * num_images images = pipe(prompt).images |
این قابلیت برای انتخاب بهترین خروجی بسیار کاربردی است.
گام هشتم: تغییر ابعاد تصویر
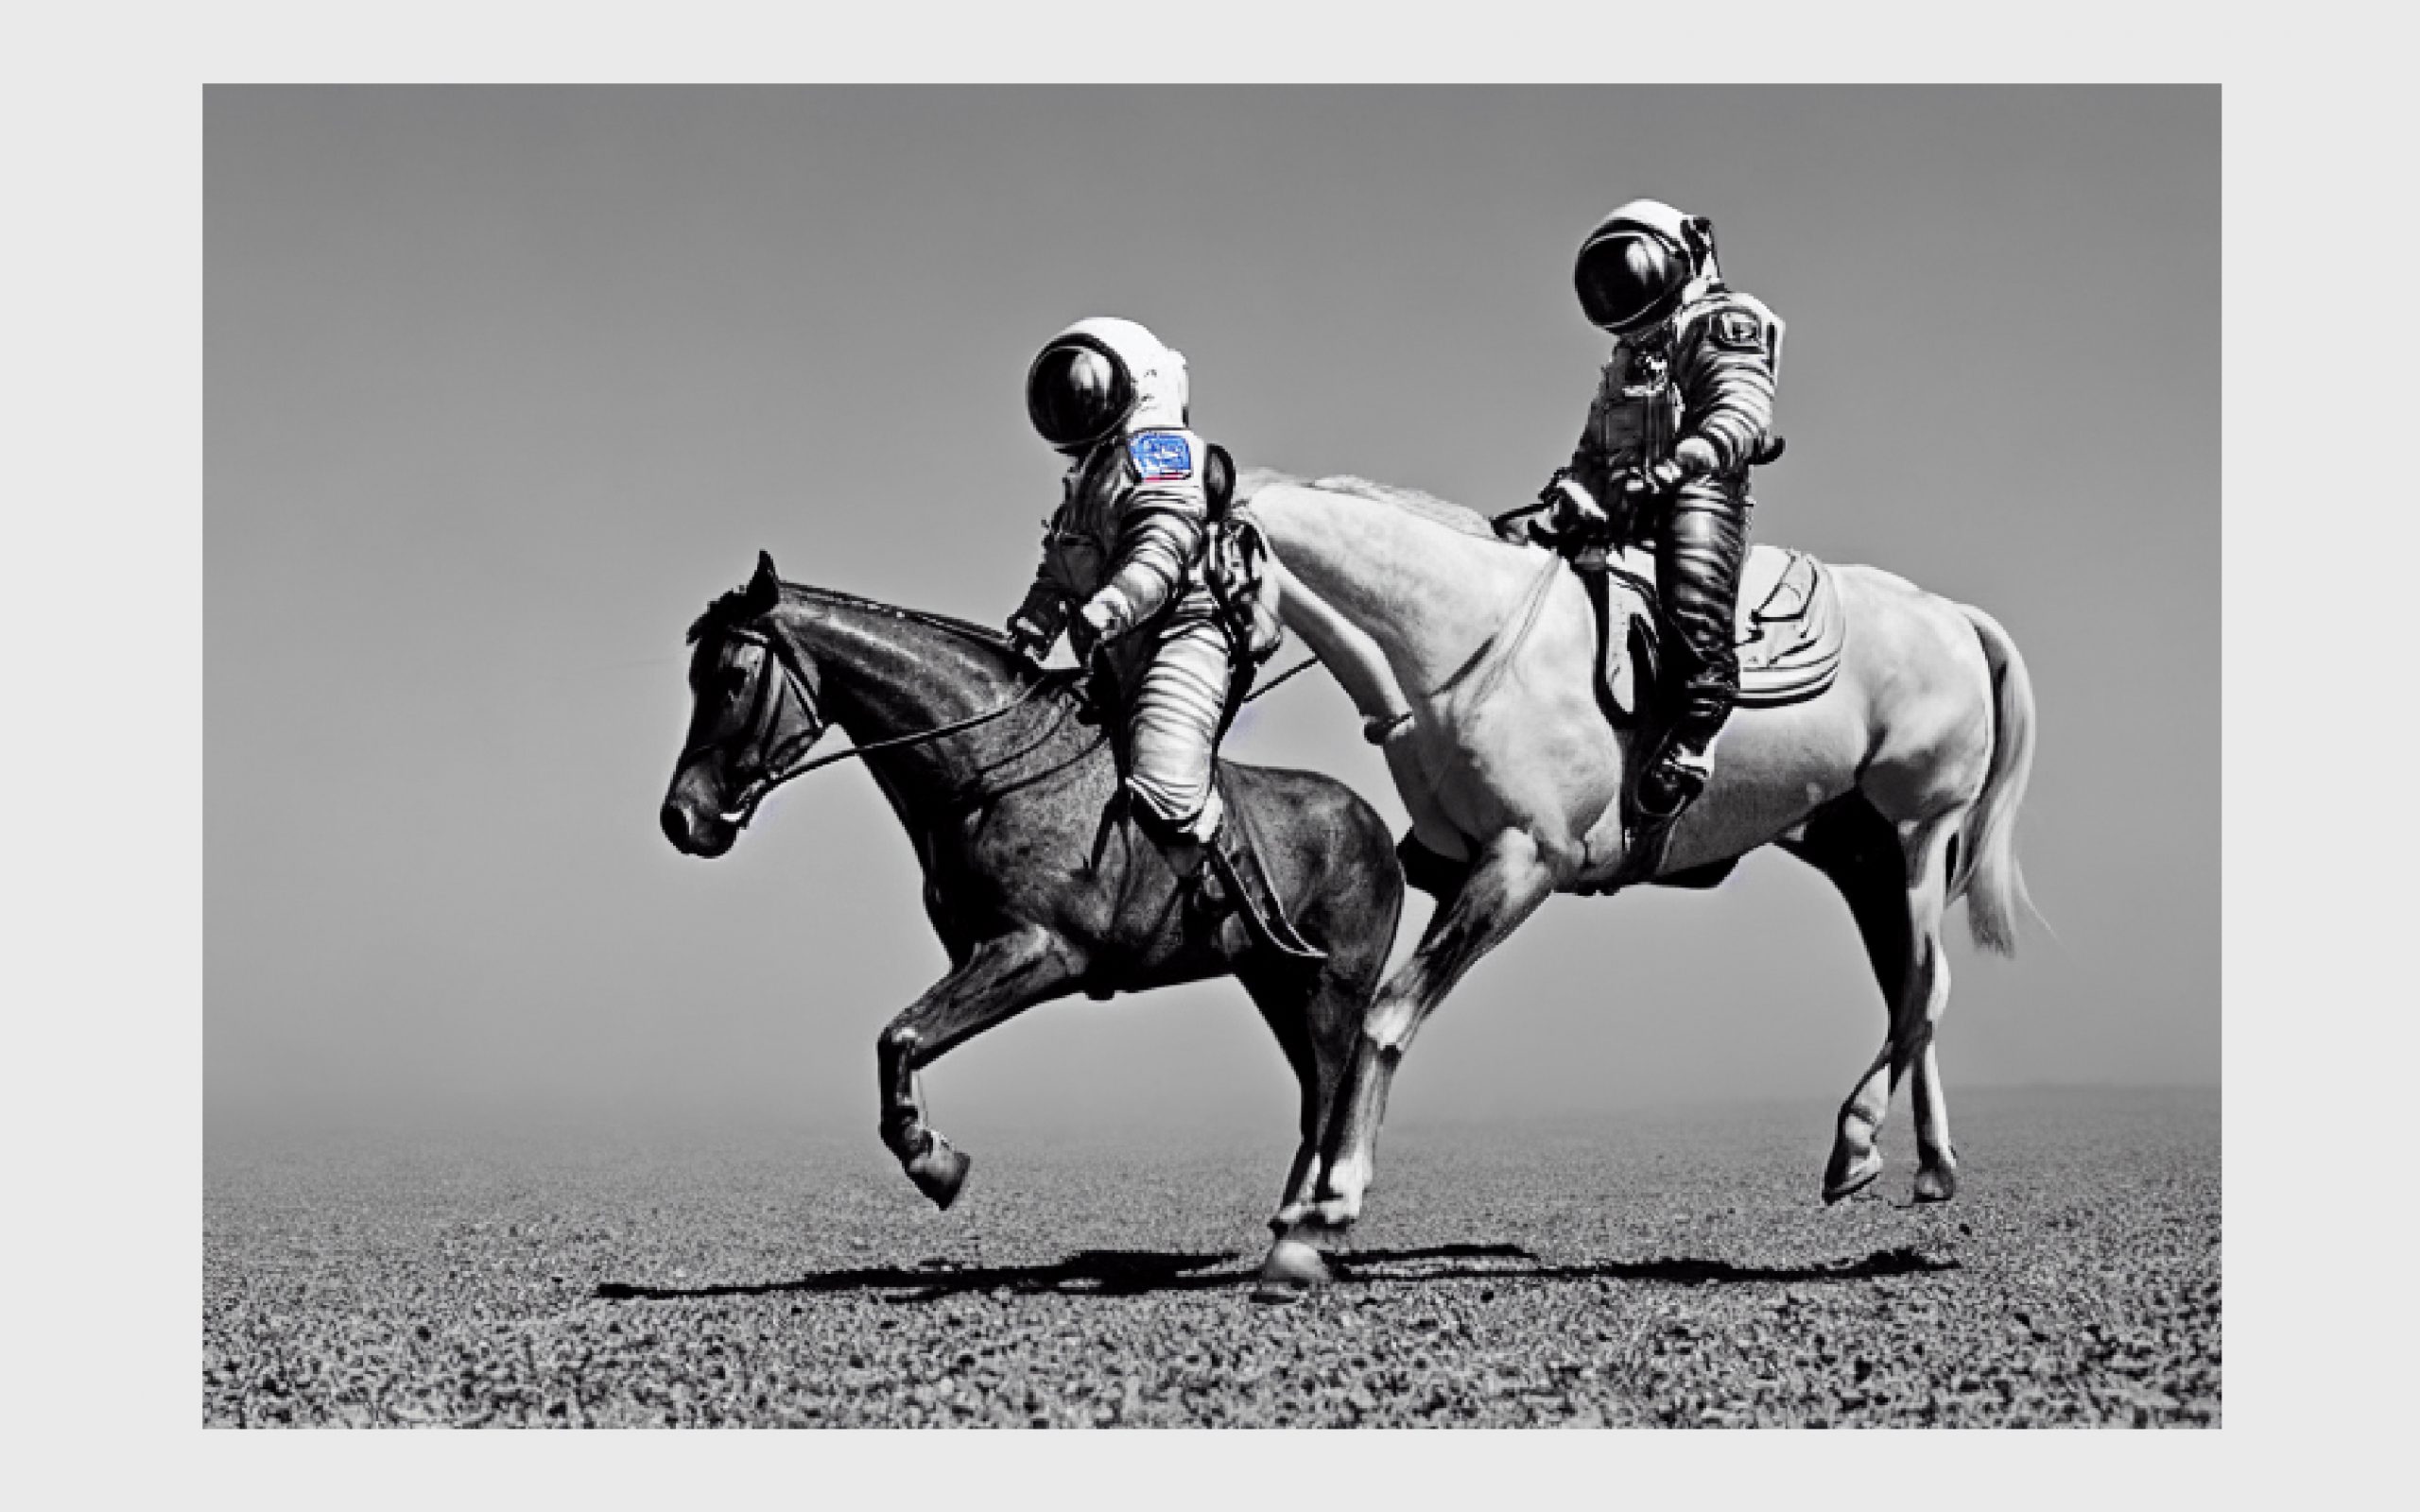
Stable Diffusion بهصورت پیشفرض تصاویر 512×512 تولید میکند، اما میتوان ابعاد تصویر را تغییر داد.
|
1 2 3 4 5 |
image = pipe( prompt, height=512, width=768 ).images[0] |
معمولا بهتر است:
- ابعاد تصویر مضرب 8 باشند
- حداقل یکی از ابعاد برابر 512 باشد
- ابعاد بسیار بزرگ انتخاب نشوند، چون ممکن است کیفیت تصویر کاهش پیدا کند
این انعطافپذیری باعث میشود Stable Diffusion بتواند تصاویر مربعی، عمودی و افقی تولید کند.
کاربردهای Stable Diffusion
Stable Diffusion تنها یک مدل تولید تصویر نیست و امروزه در بسیاری از حوزههای خلاقانه و تجاری استفاده میشود. انعطافپذیری بالا و امکان تولید تصویر از متن باعث شده این مدل به یکی از مهمترین ابزارهای Generative AI تبدیل شود.
- AI Art: تولید آثار هنری دیجیتال، تصاویر فانتزی و سبکهای مختلف هنری تنها با استفاده از Promptهای متنی.
- بازیسازی: ساخت Concept Art، طراحی شخصیت، محیط بازی و ایدهپردازی سریع برای پروژههای گیم.
- بازاریابی: تولید تصاویر تبلیغاتی، بنرها، محتوای شبکههای اجتماعی و کمپینهای بصری.
- تولید محتوا: تولید تصویر برای مقالات، ویدئوها، وبسایتها و محتوای دیجیتال بدون نیاز به طراحی دستی.
- هنر مفهومی: استفاده در فرایند طراحی اولیه فیلم، انیمیشن، بازی و پروژههای خلاقانه.
- ویرایش تصویر: ویرایش تصاویر با استفاده از Promptهای متنی و تغییر بخشهای مختلف تصویر.
- Inpainting: بازسازی یا حذف بخشی از تصویر و تولید محتوای جدید در همان ناحیه.
- Video Generation Pipelines: بسیاری از مدلهای مدرن تولید ویدئو از تکنیکهای Stable Diffusion برای تولید یا ویرایش فریمهای ویدئویی استفاده میکنند.
Stable Diffusion در مقابل GAN
پیش از ظهور Diffusion Models، معماری GAN یکی از مهمترین روشهای تولید تصویر محسوب میشد. اما Stable Diffusion توانست بسیاری از محدودیتهای GAN را کاهش دهد و کیفیت و کنترلپذیری بالاتری ارائه کند.
| ویژگی | GAN | Stable Diffusion |
| روش تولید تصویر | رقابت بین Generator و Discriminator | حذف تدریجی نویز از تصویر |
| Stability | آموزش ناپایدار و حساس | پایدارتر در آموزش و تولید |
| Image Quality | کیفیت بالا ولی گاهی ناپایدار | تصاویر بسیار واقعی و جزئیات بیشتر |
| Training Complexity | آموزش دشوار و حساس به تنظیمات | پیچیده اما پایدارتر |
| Controllability | کنترل محدود روی خروجی | کنترل بالا با Prompt |
| Diversity | احتمال Mode Collapse | تنوع بیشتر تصاویر |
| Prompt-Based Generation | محدودتر | بسیار قدرتمند |
| کاربرد اصلی | تولید تصویر و Deepfake | تولید تصویر، ویرایش تصویر، Inpainting و Multimodal AI |
یکی از مهمترین مشکلات GANها، پدیدهای به نام Mode Collapse بود؛ یعنی مدل ممکن بود فقط تعداد محدودی خروجی مشابه تولید کند. Stable Diffusion این مشکل را تا حد زیادی کاهش داد و توانست تصاویر متنوعتر و کنترلپذیرتری تولید کند.
علاوه بر این، Stable Diffusion بهدلیل استفاده از Promptهای متنی و مکانیزم Diffusion، انعطاف بسیار بیشتری در تولید تصویر دارد و به همین دلیل به یکی از مهمترین مدلهای مدرن Image Generation تبدیل شده است.
آینده Stable Diffusion و مدلهای Generative
مدلهای Diffusion بهسرعت در حال پیشرفت هستند و بسیاری از پژوهشگران معتقدند نسل بعدی سیستمهای هوش مصنوعی خلاق بر پایه همین معماریها ساخته خواهد شد. Stable Diffusion تنها نقطه شروعی برای مدلهای مولد چندرسانهای است و کاربردهای آن هر روز گستردهتر میشود.
Multimodal Generation
مدلهای جدید بهسمت تولید همزمان متن، تصویر، صدا و ویدئو حرکت میکنند. در آینده، سیستمهای Multimodal میتوانند تنها با یک Prompt، چند نوع محتوا را بهصورت هماهنگ تولید کنند.
Video Diffusion
یکی از مهمترین مسیرهای توسعه، مدلهای Video Diffusion هستند. این مدلها تلاش میکنند ویدئوهای طولانیتر، پایدارتر و واقعگرایانهتری تولید کنند و محدودیتهای فعلی در حفظ consistency میان فریمها را کاهش دهند.
Real-Time Generation
مدلهای آینده احتمالا قادر خواهند بود تصاویر و ویدئوها را بهصورت Real-Time تولید کنند. این موضوع میتواند کاربردهای گستردهای در بازیها، تولید محتوا و سیستمهای تعاملی ایجاد کند.
AI Filmmaking
هوش مصنوعی بهتدریج وارد فرایند فیلمسازی نیز شده است. مدلهای Generative میتوانند در تولید صحنه، طراحی کاراکتر، جلوههای ویژه و حتی ساخت کامل ویدئو نقش داشته باشند.
Personalized Models
یکی دیگر از روندهای مهم، مدلهای شخصیسازیشده هستند. کاربران میتوانند مدلهایی بسازند که سبک هنری، چهره یا سلیقه بصری خاصی را یاد گرفته باشند و تصاویر اختصاصی تولید کنند.
جمعبندی
Stable Diffusion یکی از مهمترین تحولهای حوزه Image Generation محسوب میشود؛ زیرا توانست تولید تصویر با هوش مصنوعی را در دسترستر، انعطافپذیرتر و کنترلپذیرتر کند. این مدل نشان داد که میتوان تنها با Promptهای متنی، تصاویر بسیار واقعی و خلاقانه تولید کرد.
ظهور Stable Diffusion همچنین باعث شد مدلهای Diffusion به رقیب جدی GANها تبدیل شوند و مسیر جدیدی در توسعه Generative AI شکل بگیرد. امروزه بسیاری از سیستمهای مدرن تولید تصویر و ویدئو از همین معماریها استفاده میکنند.
مهمترین takeaway برای دولوپرها این است که درک مفاهیمی مانند Diffusion Models، Prompt Engineering و مدلهای Multimodal به یکی از مهارتهای کلیدی در پروژههای AI تبدیل شده است؛ زیرا آینده بسیاری از ابزارهای تولید محتوا و سیستمهای خلاقانه به این فناوریها وابسته خواهد بود.
منابع
huggingface.co | medium.com | aws.amazon.com
سوالات متداول
مهمترین تفاوت Stable Diffusion متنباز بودن آن است. دولوپرها میتوانند مدل را شخصیسازی و روی سیستم خود اجرا کنند، در حالی که بسیاری از ابزارهای دیگر محدودتر هستند.
بله، نسخه اصلی Stable Diffusion متنباز است و بسیاری از ابزارهای مبتنی بر آن رایگان یا قابل اجرا روی سیستم شخصی هستند.
معمولا به GPU مناسب نیاز دارید، مخصوصا کارتهای گرافیک NVIDIA با VRAM کافی. البته نسخههای سبکتر برای سیستمهای ضعیفتر هم وجود دارند.
بله. یکی از مزیتهای اصلی آن امکان اجرای لوکال روی سیستم شخصی بدون نیاز به اتصال دائمی اینترنت است.
بله. دولوپرها میتوانند با روشهایی مثل LoRA و DreamBooth مدل را برای سبک یا شخصیت خاص آموزش دهند.


دیدگاهتان را بنویسید