
پایگاه داده برداری (Vector Database) نوعی پایگاه داده است که برای ذخیرهسازی، مدیریت و جستوجو در میان بردارهای عددی طراحی شده است. این بردارها معمولا با استفاده از مدلهای هوش مصنوعی از دادههایی مانند متن، تصویر و صوت تولید میشوند و ویژگیهای معنایی یا محتوایی آنها را نمایش میدهند. به کمک این ساختار، میتوان دادههای مشابه یا مرتبط را پیدا کرد؛ حتی زمانی که کلمات دقیق پرسوجو با محتوای دادهها یکسان نیستند.
در این مقاله، با نحوه کار پایگاه داده برداری، تفاوت آن با پایگاههای داده سنتی، الگوریتمهای جستوجوی برداری و ابزارهای پرکاربرد این حوزه آشنا میشویم. همچنین کاربردهای این فناوری در جستوجوی معنایی و سامانههای تولید افزوده بر بازیابی (RAG) و معیارهای انتخاب یک پایگاه داده برداری را بررسی میکنیم.
پایگاه داده برداری چیست؟
پایگاه داده برداری علاوه بر ذخیرهسازی بردارهای عددی، امکان سازماندهی و بازیابی آنها را بر اساس میزان شباهت فراهم میکند. در این پایگاه دادهها، هر بردار میتواند با یک شناسه و اطلاعات تکمیلی (Metadata) همراه باشد تا نتایج جستوجو بر اساس معیارهای مشخص محدود یا مرتب شوند.
برای مثال، در یک سامانه جستوجوی تصویر، ممکن است بخواهیم تصاویری مشابه تصویر ورودی پیدا کنیم؛ بدون اینکه نام فایل یا برچسب تصاویر با ورودی یکسان باشد. پایگاه داده برداری با مقایسه بردارها میتواند تصاویر نزدیک به نمونه ورودی را بازیابی کند. در این فرایند، کیفیت نتایج به مدل تولیدکننده بردارها و روش جستوجو نیز بستگی دارد.
هدف از استفاده از این پایگاه دادهها، فراهمکردن زیرساختی برای جستوجوی شباهت در مجموعهدادههای بزرگ است. قابلیتهایی مانند ایندکسگذاری، فیلترگذاری بر اساس متادیتا و جستوجوی تقریبی نزدیکترین همسایهها (ANN) به پیادهسازی این فرایند کمک میکنند.
ویژگیهای کلیدی پایگاه داده برداری
- جستوجوی مبتنی بر شباهت: بازیابی بردارهایی که بر اساس معیار انتخابشده به بردار ورودی نزدیکتر هستند.
- ایندکسگذاری و مقیاسپذیری: بهبود کارایی جستوجو در مجموعهدادههای بزرگ، متناسب با معماری و تنظیمات پایگاه داده.
- فیلترگذاری بر اساس متادیتا: محدودکردن نتایج به مواردی که ویژگیهای مشخصی دارند؛ برای مثال، تصاویر یک دستهبندی خاص یا اسناد مربوط به یک بازه زمانی.
- پشتیبانی از کاربردهای مختلف: استفاده در جستوجوی معنایی، سیستمهای پیشنهادگر و سامانههای بازیابی اطلاعات مانند RAG.
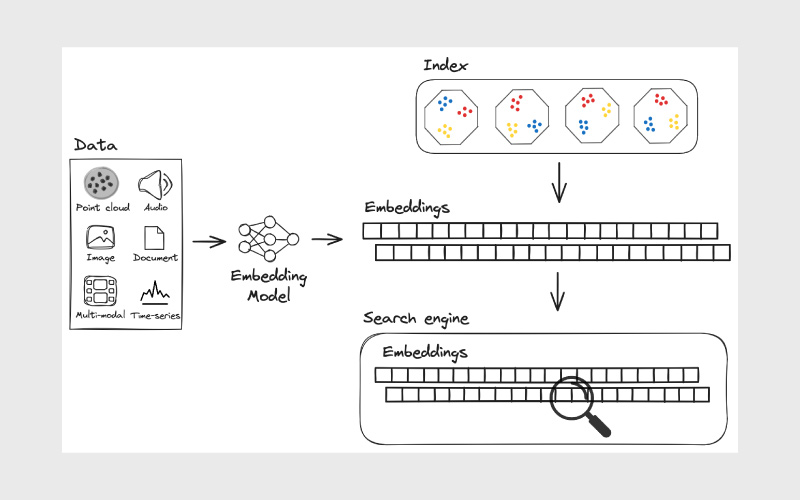
مکانیزم داخلی: Embeddings و جستجوی برداری
برای درک نحوه کار پایگاه داده برداری، ابتدا باید با مفهوم Embedding آشنا شویم.
Embedding فرایندی است که در آن یک مدل یادگیری ماشین، دادههایی مانند متن یا تصویر را به برداری عددی در یک فضای چندبعدی تبدیل میکند. این بردار، ویژگیهای آموختهشده مدل از داده را نمایش میدهد؛ به همین دلیل، دادههایی که از نظر معنایی یا محتوایی به یکدیگر نزدیک هستند، ممکن است بردارهای مشابهی داشته باشند.
برای مثال، مدل Embedding ممکن است جملههای «من به فوتبال علاقه دارم» و «بازی فوتبال جذاب است» را به بردارهایی نزدیک به یکدیگر تبدیل کند. میزان نزدیکی این بردارها به مدل، دادههای آموزشی و معیار سنجش شباهت بستگی دارد.
فرایند جستوجو در پایگاه داده برداری
جستوجو در یک پایگاه داده برداری معمولا مراحل زیر را طی میکند:
۱. تولید بردار: دادههای موردنظر، مانند متن یا تصویر، با استفاده از یک مدل مناسب به بردار عددی تبدیل میشوند.
۲. ذخیرهسازی و ایندکسگذاری: بردارها به همراه شناسه و در صورت نیاز متادیتای مرتبط، در پایگاه داده ذخیره میشوند. برای سرعتبخشیدن به جستوجو، ممکن است ساختارهای ایندکس نیز ایجاد شوند.
۳. تبدیل پرسوجو به بردار: ورودی کاربر با استفاده از مدل مناسب به بردار تبدیل میشود. برای مقایسه معتبر، مدل و فضای برداری پرسوجو باید با دادههای ذخیرهشده سازگار باشند.
۴. بازیابی نزدیکترین بردارها: پایگاه داده بردار پرسوجو را با بردارهای ذخیرهشده مقایسه میکند و نتایج نزدیکتر را بر اساس معیار انتخابشده بازمیگرداند. در مجموعهدادههای بزرگ، ممکن است از روشهای جستوجوی تقریبی نزدیکترین همسایه (ANN) استفاده شود.
معیارهای سنجش شباهت و فاصله
برای مقایسه بردارها، از معیارهای مختلفی استفاده میشود که هرکدام ویژگیهای خاص خود را دارند:
- شباهت کسینوسی (Cosine Similarity): میزان شباهت جهت دو بردار را میسنجد و به بزرگی بردارها وابستگی مستقیم ندارد.
- فاصله اقلیدسی (Euclidean Distance): فاصله هندسی میان دو بردار را محاسبه میکند.
- ضرب داخلی (Dot Product): حاصلضرب داخلی دو بردار را محاسبه میکند و مقدار آن میتواند به جهت و بزرگی بردارها وابسته باشد.
انتخاب معیار مناسب به نوع داده، مدل Embedding و نحوه آموزش آن بستگی دارد. بنابراین، نمیتوان یک معیار را برای تمام کاربردها بهترین گزینه دانست.
تفاوت پایگاه داده برداری با پایگاه داده سنتی
تفاوت اصلی پایگاه داده برداری با پایگاههای داده سنتی، در نوع جستوجو و شیوه بازیابی اطلاعات است. پایگاههای داده رابطهای معمولا برای پرسوجوهای ساختیافته و تطبیق مقادیر بر اساس شرطهای مشخص استفاده میشوند؛ در مقابل، پایگاههای داده برداری برای پیدا کردن دادههایی طراحی شدهاند که بردارهای آنها از نظر معنایی یا ویژگیهای عددی به یکدیگر نزدیکاند.
| معیار مقایسه | پایگاه داده رابطهای | پایگاه داده برداری |
|---|---|---|
| روش اصلی بازیابی | تطبیق مقادیر با شرطهای مشخص | جستوجو بر اساس شباهت بردارها |
| نوع پرسوجو | شرطهایی مانند شناسه، تاریخ یا وضعیت | یافتن موارد مشابه یک متن، تصویر یا بردار |
| کاربرد متداول | مدیریت سفارشها، کاربران و تراکنشها | جستوجوی معنایی، بازیابی اطلاعات و سامانههای RAG |
| معیار تطبیق | برابری، بازه مقادیر و سایر شرطهای پرسوجو | معیارهایی مانند شباهت کسینوسی یا فاصله اقلیدسی |
این تفاوت به معنای جایگزینبودن یکی با دیگری نیست. در بسیاری از سامانهها، پایگاه داده رابطهای برای نگهداری اطلاعات ساختیافته و پایگاه داده برداری برای بازیابی موارد مشابه به کار میرود و این دو میتوانند در کنار هم استفاده شوند.
فناوریهای بهینهسازی جستوجوی برداری
در پایگاههای داده برداری، جستوجوی دقیق مستلزم مقایسه بردار پرسوجو با تعداد زیادی از بردارهای ذخیرهشده است. با افزایش حجم دادهها و ابعاد بردارها، هزینه محاسباتی این فرایند میتواند افزایش پیدا کند. برای کاهش این هزینه، از روشهایی مانند جستوجوی تقریبی نزدیکترین همسایه (Approximate Nearest Neighbor یا ANN) و تکنیکهای فشردهسازی بردارها استفاده میشود.
روشهای ANN با بررسی هدفمند بخشی از فضای جستوجو، نزدیکترین بردارها را با سرعت بیشتر پیدا میکنند؛ هرچند ممکن است در مقایسه با جستوجوی دقیق، برخی از نزدیکترین نتایج را از دست بدهند. انتخاب روش مناسب به حجم دادهها، میزان دقت موردنیاز، محدودیت حافظه و زمان پاسخگویی بستگی دارد.
مهمترین الگوریتمها و روشها
- LSH (Locality-Sensitive Hashing): با استفاده از توابع هش طراحیشده برای حفظ شباهت، بردارهای مشابه را با احتمال بیشتری در دستههای یکسان قرار میدهد. این روش به محدودکردن فضای جستوجو کمک میکند.
- PQ (Product Quantization): بردارها را به زیرفضـاهای کوچکتر تقسیم و هر بخش را بهصورت فشرده کدگذاری میکند. این روش با کاهش حجم دادههای موردنیاز برای ذخیرهسازی و محاسبه، میتواند مصرف حافظه را کاهش دهد.
- HNSW (Hierarchical Navigable Small World): از ساختار گراف چندلایه برای پیمایش فضای برداری استفاده میکند و در بسیاری از کاربردها، تعادل مناسبی میان سرعت جستوجو و کیفیت نتایج فراهم میکند. بااینحال، مصرف حافظه و عملکرد آن به تنظیمات و شرایط مسئله وابسته است.
کتابخانهها و ابزارهای جستوجوی برداری
علاوه بر الگوریتمها، کتابخانههایی وجود دارند که پیادهسازی و استفاده از روشهای جستوجوی برداری را آسانتر میکنند:
- FAISS (Facebook AI Similarity Search): کتابخانهای متنباز برای جستوجوی شباهت و مدیریت ایندکسهای برداری که روشهای متنوعی برای جستوجوی دقیق، جستوجوی تقریبی و فشردهسازی ارائه میدهد.
- Annoy (Approximate Nearest Neighbors Oh Yeah): کتابخانهای برای جستوجوی تقریبی نزدیکترین همسایهها که از درختهای جستوجوی تصادفی استفاده میکند و برای برخی کاربردهای جستوجوی برداری مناسب است.
- ScaNN (Scalable Nearest Neighbors): کتابخانهای برای جستوجوی کارآمد نزدیکترین همسایهها که از روشهایی مانند فشردهسازی بردارها و رتبهبندی مجدد نتایج استفاده میکند.
این ابزارها از نظر روشهای جستوجو، مصرف حافظه، امکانات اجرایی و نحوه استقرار تفاوت دارند؛ بنابراین، انتخاب میان آنها باید بر اساس نیاز پروژه انجام شود. همچنین باید توجه داشت که کتابخانه جستوجوی برداری لزوماً تمام قابلیتهای یک پایگاه داده برداری، مانند مدیریت متادیتا، فیلترگذاری و عملیات ذخیرهسازی را ارائه نمیدهد.
تفاوت جستوجوی برداری، معنایی و ترکیبی
جستوجوی برداری، جستوجوی معنایی و جستوجوی ترکیبی به مفاهیم مرتبطی اشاره دارند، اما یکسان نیستند. شناخت تفاوت آنها به انتخاب روش مناسب برای بازیابی اطلاعات کمک میکند.
- جستوجوی برداری (Vector Search): در این روش، بردار پرسوجو با بردارهای ذخیرهشده مقایسه میشود تا نزدیکترین موارد بر اساس معیاری مانند شباهت کسینوسی یا فاصله اقلیدسی پیدا شوند. این روش بهتنهایی تضمین نمیکند که نتایج از نظر معنایی مرتبط باشند؛ کیفیت آن به مدل تولید بردار و دادهها نیز بستگی دارد.
- جستوجوی معنایی (Semantic Search): هدف آن پیدا کردن نتایجی است که از نظر معنا به پرسوجوی کاربر مرتبطاند، حتی اگر کلمات دقیقا یکسان نباشند. این قابلیت اغلب با استفاده از embeddingها و جستوجوی برداری پیادهسازی میشود.
- جستوجوی ترکیبی (Hybrid Search): در این روش، نتایج جستوجوی برداری با نتایج جستوجوی کلیدواژهای ترکیب میشوند تا هم شباهت معنایی و هم تطابق دقیق واژهها در بازیابی اطلاعات نقش داشته باشند.
برای مثال، در جستوجوی مستندات فنی، جستوجوی برداری میتواند اسناد مرتبط از نظر مفهومی را پیدا کند؛ جستوجوی معنایی بر ارتباط آنها با مفهوم پرسوجو تمرکز دارد و جستوجوی ترکیبی میتواند این نتایج را با تطبیق دقیق عباراتی مانند نام محصول یا کد خطا تکمیل کند.
پایگاه داده برداری چگونه کار میکند؟
تفاوت اصلی پایگاه داده برداری با بسیاری از روشهای متداول جستوجو، در نحوه پیدا کردن نتایج مرتبط است. در جستوجوی مبتنی بر تطبیق دقیق، سیستم بهدنبال مقادیری میگردد که با شرط جستوجو مطابقت دارند؛ اما در جستوجوی برداری، نتایج بر اساس میزان شباهت میان بردار پرسوجو و بردارهای ذخیرهشده انتخاب میشوند.
برای اجرای این فرایند، پایگاه داده برداری میتواند از ساختارهای ایندکسگذاری و الگوریتمهای جستوجوی دقیق یا تقریبی استفاده کند. انتخاب روش به عواملی مانند حجم دادهها، سرعت پاسخگویی موردنیاز، مصرف حافظه و دقت بازیابی بستگی دارد.
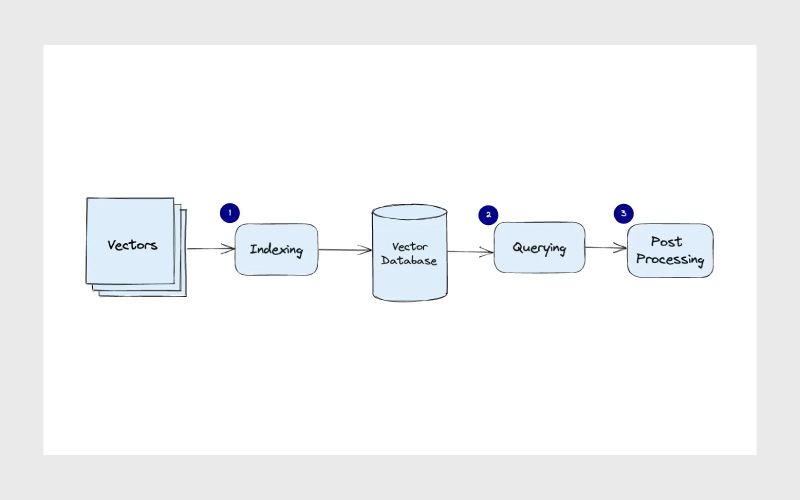
۱. آمادهسازی و ایندکسگذاری دادهها (Indexing)
پس از تولید بردارها با استفاده از یک مدل Embedding، بردارها در پایگاه داده ذخیره میشوند. سیستم میتواند با استفاده از ساختارهایی مانند HNSW یا روشهایی مانند LSH و Product Quantization، جستوجو در میان آنها را بهینه کند. نوع ساختار مورد استفاده به محصول و تنظیمات آن بستگی دارد.
۲. دریافت پرسوجو و بازیابی نتایج (Querying)
در زمان جستوجو، ورودی کاربر در صورت نیاز به بردار تبدیل میشود. سپس پایگاه داده با استفاده از معیار انتخابشده، بردارهای مرتبط را پیدا میکند و نتایج را بر اساس میزان شباهت یا فاصله مرتب میکند. در روشهای ANN، سیستم برای کاهش هزینه محاسباتی ممکن است تنها بخشی از فضای جستوجو را بررسی کند؛ بنابراین تضمینی وجود ندارد که همیشه دقیقترین همسایهها پیدا شوند.
۳. فیلترگذاری و پردازش نتایج
بسته به قابلیتهای سیستم، میتوان نتایج را بر اساس متادیتا فیلتر کرد؛ برای مثال، فقط اسناد مربوط به یک بازه زمانی مشخص را در نظر گرفت. در برخی سامانهها، نتایج اولیه با یک روش دیگر دوباره رتبهبندی میشوند تا موارد مرتبطتر در جایگاه بالاتری قرار بگیرند. این مرحله اختیاری است و ممکن است خارج از پایگاه داده برداری انجام شود.
در نهایت، کیفیت جستوجو به ترکیبی از مدل Embedding، معیار شباهت، روش ایندکسگذاری، تنظیمات جستوجو و در صورت استفاده، مراحل بازرتبهبندی بستگی دارد. به همین دلیل، انتخاب روش مناسب معمولا مستلزم ارزیابی همزمان سرعت و کیفیت نتایج است.
مقایسه چند پایگاه داده برداری پرکاربرد
پایگاههای داده برداری مختلفی برای ذخیرهسازی و جستوجو در میان بردارهای عددی توسعه داده شدهاند. این ابزارها از نظر قابلیتهای جستوجو، مقیاسپذیری، امکانات فیلترگذاری و شیوه استقرار با یکدیگر تفاوت دارند. انتخاب گزینه مناسب به نیاز پروژه، حجم دادهها و منابع زیرساختی بستگی دارد.
در جدول زیر، چند نمونه از پایگاههای داده برداری پرکاربرد را مقایسه میکنیم. اگر میخواهید گزینههای بیشتری را بررسی کنید، در مقاله ۱۷ پایگاه داده برداری برتر میتوانید با ابزارهای دیگر و ویژگیهای آنها آشنا شوید.
| ابزار | نوع راهکار | ویژگی شاخص | مناسب برای |
|---|---|---|---|
| Qdrant | پایگاه داده برداری متنباز و سرویس ابری | جستوجوی برداری همراه با فیلترگذاری بر اساس متادیتا | پروژههایی با نیاز به فیلترگذاری و کنترل زیرساخت |
| Milvus | پایگاه داده برداری متنباز | پشتیبانی از بارهای کاری بزرگ و معماری مقیاسپذیر | سامانههایی با حجم زیاد داده و نیازهای مقیاسپذیری |
| Chroma | پایگاه داده متنباز | شروع ساده و تجربه توسعه مناسب برای برنامههای مبتنی بر Embedding | نمونهسازی و توسعه برنامههای RAG |
| Weaviate | پایگاه داده برداری متنباز و سرویس ابری | پشتیبانی از جستوجوی برداری و ترکیبی | برنامههایی که به ترکیب جستوجوی معنایی و کلیدواژهای نیاز دارند |
| Pinecone | سرویس مدیریتشده | ارائه زیرساخت برداری مدیریتشده | تیمهایی که ترجیح میدهند درگیری کمتری با مدیریت زیرساخت داشته باشند |
کاربردهای پایگاه داده برداری چیست؟
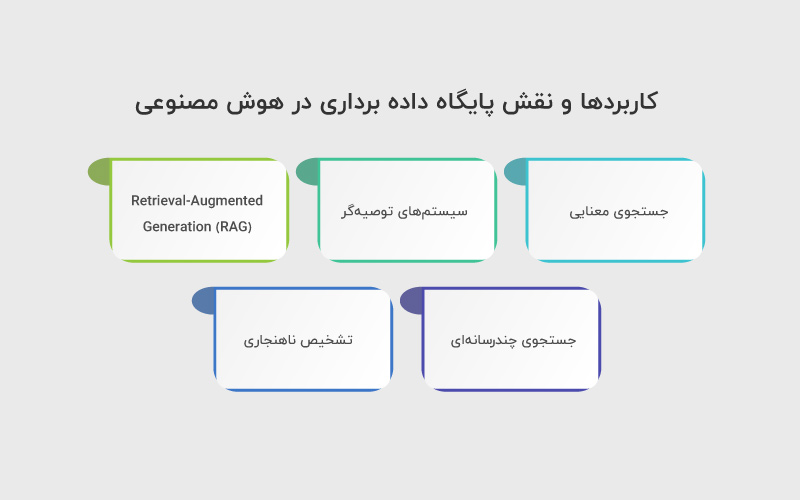
پایگاه داده برداری برای بازیابی اطلاعات بر اساس شباهت معنایی یا ویژگیهای محتوایی استفاده میشود. این قابلیت در سیستمهای هوش مصنوعی، از جستوجوی معنایی و پیشنهاد محصول گرفته تا بازیابی اطلاعات برای مدلهای زبانی، کاربرد دارد. در ادامه، مهمترین کاربردهای این پایگاه داده را بررسی میکنیم.
۱. جستوجوی معنایی (Semantic Search)
در جستوجوی معنایی، نتایج فقط بر اساس تطابق کلمات کلیدی انتخاب نمیشوند؛ بلکه میزان شباهت معنایی پرسوجوی کاربر با محتوای ذخیرهشده نیز در نظر گرفته میشود. برای مثال، کاربری که در فروشگاه اینترنتی عبارت «کفش مناسب دویدن در باران» را جستوجو میکند، ممکن است محصولاتی با توضیحاتی مانند «کفش رانینگ ضدآب» ببیند؛ حتی اگر عبارت جستوجوشده عینا در عنوان محصول وجود نداشته باشد.
۲. سیستمهای پیشنهاددهنده (Recommendation Systems)
در سیستمهای پیشنهاددهنده، بردارهای مربوط به کاربران، محصولات یا محتواها میتوانند برای پیدا کردن موارد مشابه استفاده شوند. برای مثال، فروشگاه اینترنتی میتواند محصولاتی را پیشنهاد دهد که از نظر ویژگیها یا الگوی علاقهمندی، به محصولات مورد توجه کاربر شباهت دارند. پایگاه داده برداری امکان بازیابی سریع موارد مشابه را در مجموعههای بزرگ فراهم میکند؛ البته کیفیت پیشنهادها به دادهها و روش طراحی سیستم نیز وابسته است.
۳. تولید تقویتشده با بازیابی (RAG)
یکی از کاربردهای مهم پایگاه داده برداری، استفاده از آن در معماری Retrieval-Augmented Generation (RAG) است. در این روش، سیستم پیش از تولید پاسخ، اطلاعات مرتبط را از منابعی مانند اسناد سازمانی، پایگاه دانش یا مستندات فنی بازیابی میکند و آنها را در اختیار مدل زبانی قرار میدهد.
پایگاه داده برداری میتواند در این مرحله، اسناد مرتبط با پرسش کاربر را بر اساس شباهت معنایی پیدا کند. استفاده از اطلاعات بازیابیشده ممکن است به افزایش ارتباط و دقت پاسخ کمک کند و احتمال تولید پاسخهای نادرست را کاهش دهد؛ اما بهتنهایی خطای توهم در مدلهای زبانی را از بین نمیبرد.
۴. جستوجوی چندرسانهای (Multimodal Search)
پایگاه داده برداری میتواند برای بازیابی محتوای مشابه در میان تصاویر، فایلهای صوتی و سایر دادههای چندرسانهای به کار رود. در این روش، یک مدل یادگیری ماشین محتوای موردنظر را به بردار تبدیل میکند و سیستم با مقایسه بردارها، موارد مشابه را پیدا میکند. برای مثال، کاربر میتواند تصویری از یک محصول را وارد کند و تصاویر محصولات مشابه را در فروشگاه ببیند.
۵. تشخیص ناهنجاری و تقلب (Anomaly and Fraud Detection)
بردارها میتوانند الگوهای رفتاری یا ویژگیهای تراکنشها را نمایش دهند. مقایسه دادههای جدید با نمونههای مشابه یا الگوهای شناختهشده، در کنار روشهای دیگر تشخیص ناهنجاری، میتواند به شناسایی رفتارهای غیرعادی کمک کند. برای مثال، در سامانههای مالی میتوان از این رویکرد برای بررسی تراکنشهای مشکوک استفاده کرد. البته تشخیص تقلب معمولا به مدلها و قواعد تکمیلی نیاز دارد و صرفا با جستوجوی برداری انجام نمیشود.
جمعبندی
پایگاه داده برداری یکی از ابزارهای مهم برای جستوجوی شباهت در کاربردهای هوش مصنوعی، از جمله جستوجوی معنایی و RAG است. انتخاب ابزار مناسب به نیاز پروژه، حجم دادهها و الزامات سرعت و دقت بستگی دارد.
منابع
developers.cloudflare.com | pinecone.io
سوالات متداول
پایگاه داده سنتی دادهها را به صورت جداولی شامل اعداد، رشتهها و مقادیر دقیق ذخیره میکند. اما پایگاه داده برداری (Vector Database) دادهها را به شکل بردارهای چندبعدی ذخیره و مدیریت میکند. این نوع پایگاه داده بهجای جستجوی تطابق دقیق، با استفاده از معیارهای شباهت (مثل کسینوس سیمیلتری یا فاصله اقلیدسی) نزدیکترین بردارها را پیدا میکند. بنابراین، بهویژه در کاربردهایی مثل جستجوی معنایی، پردازش تصویر و دادههای غیرساختاریافته کارایی بالاتری دارد.
بله. بسیاری از سازمانها از Hybrid Database Systems استفاده میکنند که دادههای ساختاریافته (SQL/NoSQL) و غیرساختاریافته (Vector) را با هم مدیریت میکنند. برای مثال میتوان اطلاعات مشتری (نام، ایمیل، شماره) را در یک پایگاه داده رابطهای ذخیره کرد و بردارهای رفتاری یا علایق او را در پایگاه داده برداری نگه داشت. این ترکیب امکان جستجوی دقیق و معنایی را همزمان فراهم میکند.
در سرویسهای ابری، هزینه معمولا بر اساس حجم ذخیرهسازی، تعداد درخواست جستجو، و توان پردازشی (CPU/GPU) محاسبه میشود. این مدل برای پروژههایی که مقیاس آنها قابل پیشبینی نیست یا به سرعت رشد میکنند مناسبتر است.
در مدل On-Premise (نصب محلی)، هزینه بیشتر مربوط به زیرساخت سختافزاری، نگهداری و مدیریت سیستم است. این گزینه برای سازمانهایی که ملاحظات امنیتی و حریم خصوصی سختگیرانه دارند ترجیح داده میشود، اما هزینه اولیه بیشتری دارد.



دیدگاهتان را بنویسید